概要
attention ヘッドは解釈と介入の単位として広く使われている。しかし、単一のヘッドへの介入がそのヘッド専用のチャネルの中に留まるとは限らず、したがってその効果がそのヘッドの計算だけを反映するとも限らない。ヘッド単位の介入をより正確に評価するため、本研究はヘッド間の overlap を制御する内在的なアプローチを取る。ヘッドの部分空間がどう overlap するかを読み書き幾何として固定した Transformer を訓練し、3 つのタスクですべてのヘッドにパッチを当て、ヘッドを排他的にすれば効果が集中するのかを問う。得られた知見は 3 つである。第一に、ヘッド単位の介入は排他的ではない。あるヘッドへの摂動は後続のすべてのヘッドに届き、とりわけタスクに関与するヘッドに最も強く届く。第二に、排他性は overlap を除去するのではなく再配分する。書き込み空間が残差ストリームを直交分解するとき、各読み手が受け取る overlap の総量は保存され、排他的な設計では効果はヘッドからヘッドインデックスへと移り、インデックス内の層にまたがって広がった。一貫してより集中することはなかった。第三に、幾何は組織を形づくる。層間で共有された書き込み空間はタスクに関与するヘッドを同一インデックスのレーンに整列させ、ヘッドの value 読み取り空間は自身の書き込み空間と整列する。これに対してヘッド単位の集中は、単一シードの比較の範囲ではタスク間で一貫して増加せず、現れた場合も読み手の制限と容量の低下に付随していた。したがって、幾何的排他性と機能的集中は一致するとは限らない。
1 Introduction
attention ヘッドは Transformer の計算の意味ある単位として扱われるのが通例である。個々のヘッドや疎なヘッド集合は、統語関係 (Clark et al., 2019; Voita et al., 2019)、induction (Olsson et al., 2022)、コピー (Wang et al., 2023)、タスク表現 (Todd et al., 2024)、文法数 (Ferrando and Costa-jussà, 2024)、真実性 (Li et al., 2023) と結び付けられてきた。この見方は対応する介入の方法論を生んだ。重要なヘッドを特定し、その活性を改変し、行動の変化をそのヘッドに帰属させるというものである。Inference-Time Intervention (Li et al., 2023) や function vectors (Todd et al., 2024) のようなステアリング手法は、この帰属に実際的な重みを与える。ヘッド単位の介入は、残差ストリーム全体への介入よりはるかに局所的に見えるからである。
しかし、介入がどこに適用されるかと、その結果生じる摂動がどの計算チャネルを占めるかは別の事柄である。先行研究で我々は、ヘッドの読み取り部分空間と書き込み部分空間が一般に disjoint だが非直交であることを示した (Uehara and Santo, 2026)。したがって、あるヘッドを通して書き込まれたベクトルは、どの非零ベクトルも両方には属さないにもかかわらず、一般に他のヘッドが読む部分空間に非零成分を持つ。介入は 1 つのヘッドに曖昧さなく位置づけられながら、そのヘッドだけに結び付いたチャネルに排他的でないことがありうる。我々の関心は、ヘッドのパッチ効果が下流の計算を含むこと(これは効果を介入部位に帰属させることと両立する)ではなく、介入の局所性がそれの使うチャネルの排他性についての結論を正当化するかどうかにある。
自然な仮説は、この非排他性こそが機能的効果をヘッド間に拡散させるのだから、ヘッド間の非直交な読み書き結合を取り除けばヘッド単位の介入の効果は集中するはずだ、というものである。我々はこれを内在的なアプローチで検証する。訓練済みモデルの幾何を分析するのではなく、幾何を実験変数として扱い、訓練に組み込む。書き込み空間、読み取り空間、あるいはその両方を設計した部分空間に凍結したモデルを訓練する。そこには、どのヘッドも他のインデックスのヘッドの attention 書き込みを読めないモデルが含まれる。そのうえで、3 つのタスクが因果的効果をどこに置くかを測る。
我々の実験は、幾何的排他性と機能的集中の単純な結び付きを支持しなかった。この結び付きの検証で区別し測定する性質を表 1 にまとめる。本稿の貢献は次のとおりである。
-
実際のヘッドパッチ摂動の方向的 leakage の測定。learned モデルと
write-common-axisモデルでは、摂動は後続のすべてのヘッドの folded 読み取り空間に射影され、とりわけ他のタスク関与ヘッドの query に、部分空間の予測を超えて最も強く射影される。 -
幾何的排他性が機能的集中を含意しないことの、21 の訓練済み構成からの証拠。単一シードの比較では、ヘッドインデックス間で排他的な overlap の配分は一様な配分に比べて集中を一貫して高めず、コーパス S では読み手を自由にしたまま書き込みを凍結すると、同数のヘッドを持つモデルで 3 タスクすべてにおいて効果が拡散した。ヘッド単位の集中とインデックス単位の集中は乖離する。SVA と quote では、排他的設計は層内置換が与えるより少ないヘッドインデックスに効果を集中させる一方、インデックス内ではより多くの層に広げるので、似たヘッド単位の値が異なる構造を隠している。
-
幾何の正の組織効果。共有された書き込み空間はタスクに関与するヘッドを同一インデックスのレーンに整列させる。レーンはタスクの学習後に形成され、単一ヘッドのクランプではリレーとして選好されなかった(ただし 1 つのモデル・タスクでのレーン一括クランプでは選好された)。この効果は 2 つのコーパスで独立に訓練された共有書き込みモデルにわたって再現し、SVA で最も明瞭である。ほとんどのモデルは 1 シードである。
-
value の読み書き自己整列が、評価した 8 つの自由読み手モデルすべてで生じ、勾配降下の初期に形成され、学習された書き込みで最も強いことの証拠。
-
ヘッド単位の介入の部位と、その摂動が届きうる読み取り部分空間とを分離する枠組み。その保存恒等式(命題 1)は直交分解に対するトレース恒等式であり、我々の設計が操作する量を明示する。書き込みが残差ストリームを直交分解するとき、読み手が受け取る overlap の総量は固定されるので、他インデックスのヘッドとの overlap は再配分できるが除去はできない。
2 Related Work
ヘッド単位の介入と機能の帰属。 attention ヘッドは機構的解釈の単位として長く使われてきた。初期の研究はヘッドの専門化した言語機能と冗長性を特定し (Clark et al., 2019; Voita et al., 2019; Michel et al., 2019)、その後の研究はヘッド単位の介入を使って回路を特定し、モデルの挙動をステアリングした (Wang et al., 2023; Li et al., 2023; Todd et al., 2024)。しかし、介入の位置は、影響を受けた計算がその部品に排他的であることを立証しない。Makelov et al. (2024) は部分空間介入が休眠経路を活性化しうることを示し、Vaidyanathan et al. (2026) は activation patching の効果が他の部品との相互作用を含みうることを示した。Nam et al. (2025) はヘッドの役割が他のヘッドとの相互作用に依存することを見出し、Christensen et al. (2026) は直交する表現の上の独立な計算が独立なヘッドに割り当てられる必要はないことを示した。これらの研究は部品単位の効果の素朴な解釈に異議を唱える。我々の問いは相補的である。訓練時にヘッド間の幾何的結合を制御すると、介入効果の集中が変わるかどうかである。
読み書き幾何とヘッド間通信。 残差ストリームの枠組みは、Transformer の部品を共有された表現空間から読み、そこへ書くものとして記述し、attention ヘッドは Q・K・V composition を通して相互作用する (Elhage et al., 2021)。Merullo et al. (2024) は層間の低ランク通信チャネルを特定し、重み行列からヘッドの相互作用を予測した。Yamagiwa et al. (2026) は projection kernel を使って attention ヘッド部分空間の関係を測り、既知の相互作用を復元した。OV 作用素の関連分析は、構造化された向きと近似的な scaled-idempotence を特定している (Trockman and Kolter, 2023; Feng and Li, 2026)。これらの研究は学習済みモデルの幾何的関係を特徴づける。この視点の上に、我々は読み書き幾何を実験変数として扱い、実際のヘッドパッチ摂動が届く方向を測り、結果として生じる結合がタスク効果とどう関係するかを調べる。
設計された幾何と計算の組織化。 Transformer に構造的制約を課して計算を解釈しやすくするアプローチがいくつかある。Tracr は人間に読めるプログラムを既知の計算構造を持つ Transformer にコンパイルする (Lindner et al., 2023)。Transformer Programs と Adaptive Transformer Programs は、最適化を通して学習される解釈可能な計算を支える制約付き表現とモジュールを導入する (Friedman et al., 2023; Lai-Dang et al., 2025)。attention ヘッド間の多様性を促す研究 (Li et al., 2018; Yun et al., 2021) や、多層ヘッド回路の出現を調べた研究 (Muşat, 2025) もある。我々の目的は、解釈可能なプログラムの構築やヘッド多様性の促進とは異なる。意図的に割り当てた読み書き部分空間を持つ Transformer を訓練し、層間結合の排他的な配分と分散した配分を比較し、単一ヘッド介入効果の集中とタスク関与ヘッドの層間整列の両方を評価する。これにより、幾何的排他性・機能的集中・層間組織を別個の経験的性質として区別する。
3 Framework
3 つのレベルの読み取り空間と書き込み空間。 列ベクトルを使い、、 とする。層 のヘッド について、 の と をとる。書き込み空間は である。各ヘッドは LayerNorm を通して残差ストリームを読むので、3 つの対象を区別し、すべての結果はどれを使うかを明記する。第一は重み空間の読み取り空間
添字 は正規化を折り込んでいないことを示す。設計された幾何(図 1、表 2)、PK とエッジの分析、自己整列の測定はこのレベルを使う。
第二は、先行研究 (Uehara and Santo, 2026) の規約に従う folded 読み取り空間 である。層とヘッドの添字を省き、 を中心化射影、 を正規化を折り込んだ読み取り写像とすると、
5.1 節の leakage の測定はこのレベルを使う。、 と書くと、LayerNorm は である。 を のヤコビアンとすると、読み手のヤコビアンは
スケール は部分空間を変えない。ランク 1 の項は入力依存であり folded 空間には表現されない。その大きさは測っていない。ヘッドごとの LayerNorm を持つブロック読み手では、同じ定義が 64 次元のブロック座標に適用される。中心化はそのブロック内で働くので、folded 読み取り空間は高々 63 次元である( 写像とゲインが非退化のときちょうど 63)。
第三は実際の応答、すなわち介入のもとでの読み手の入力の正確な変化であり、ネットワークを走らせて測る(5.1 節の direct と total の変化)。
overlap は共通部分ではない。 のとき は と overlap すると言う。overlap は決して を意味しない。一般のヘッド部分空間では、 でありながら である。projection kernel の定義のため、2 つの部分空間を 、その正規直交基底行列を と書く。主角 、 として、
ここで は への直交射影である。この基底行列の式の外では、 と は部分空間を表す。
命題 1(overlap は保存される) が互いに直交し ならば、任意の部分空間 について である。
証明 より 。
ブロック書き込みを凍結した 12 ヘッドのモデル(表 2 の凍結書き込みモデル)では ()であり、1 層の書き込みは残差ストリームの正規直交分解をなすので、命題 1 が適用できる。routed 対照(16 ヘッドを 768 次元に書き込む)には適用できない。適用できるモデルでは、 次元の読み手は先行する各層の書き込みからちょうど 単位の overlap を(重み空間で)受け取る。この意味での排他性はヘッドインデックスの間のものであって、ヘッドの間のものではない。共通基底は他インデックスのヘッドとの overlap を除去できるが、ヘッドは他の層の同一インデックスのヘッドと結合したままである。これをインデックス間排他性と呼ぶ。後の層 のヘッド の読み手について、他のすべてのヘッドインデックスとの overlap は
ここで は層 の同一インデックスの書き込みである。他インデックスとの overlap はゼロまで減らせるが、それはその 1 つの相手に集中させること(、all-common-axis のように)によってのみ可能である。総量は減らせない。したがって我々の操作が変えるのは overlap の配分である。同一インデックスに集中させるか、近似的に一様に(どの書き込みとも 、ランダム部分空間の期待値)広げるかである。
部位とチャネル。 を源ヘッド、 を後のヘッドとし、 とする。読み取り種別 を固定して 、 と書く。ヘッド へのパッチは を注入し、ヘッド は線形経路に沿って への射影を通してそれを読む。 ならば、 を通して排他的に書き込まれた摂動の一部が に直接届く。具体的な摂動に対して、方向的 leakage を
と定義する。例と位置についてプールし、 では読み取り種別 を省く。摂動が 内で等方的なら、対応する母集団のエネルギー比は である。leakage を測るモデルでは両空間とも 64 次元なので、これは 、以下で使う等方期待値に等しい。測定された leakage は、実際の介入方向が部分空間の幾何が示すより排他的か、そうでないかを教える。
本研究で調べる性質。 表 1 に、介入部位と、実験で調べる幾何的・機能的性質をまとめる。これらの区別は各測定が何を立証するかを特定するものであり、局所性の網羅的な分類でも、性質が互いに独立だという主張でもない。分離可能な部分計算というより強い意味でのモジュール性は、同時介入・相互作用効果・タスク間選択性を要する。我々はそれを測っておらず、結論もそれに関わらない。
| 性質 | 意味と測度 | 知見 |
|---|---|---|
| 介入部位 | どのヘッドを操作するか。実装で固定。 | --- |
| 幾何的排他性 | 注入された摂動が他のヘッド(我々の設計では他インデックスのヘッド: インデックス間排他性)の読み取り空間に成分を持たない。leakage と PK で測る。 | 測定した 5 モデル(learned、write-common-axis)には無い。すべてのパッチは後続のすべてのヘッドの folded 読み取り空間にほぼ幾何の予測どおり射影され、重要なヘッドの対は互いの query に等方期待値の で射影される(5.1 節)。 |
| 機能的集中 | 1 つのタスクで単一ヘッドパッチの効果を少数のヘッドが担う。 と単一ヘッド効果の絶対値和 で測る。 | ヘッド単位では、インデックス間排他的な overlap 配分で一貫しては増加しない。インデックス単位では、all-common-axis は全タスクで、他のいくつかのモデルは一部のタスクで層内置換を超えて集中し、しばしばインデックスあたりの層数は広がる。コーパス S の凍結書き込みでは拡散する。容量の低下と弱いタスクマージンと共変する(5.2 節)。 |
| 基底集中 | 少数の残差座標が効果を担う。 の後と前での上位 10 座標シェアで測る。 | 測定する表現に強く依存する(付録 B.2)。 |
| 組織的整列 | 重要なヘッドが層をまたいでインデックスを共有する。レーンスコア で測る。 | 層間で共有された書き込み空間で現れる。単一ヘッドのクランプでは同一インデックス対はリレーとして選好されなかったが、唯一のレーン一括クランプ(all-common-axis、SVA)では選好された(5.3 節)。 |
表 1. 本研究で調べる性質、その操作的定義、実験結果。
4 Experimental Setup
モデル。 主分析のモデルは 12 層 pre-LayerNorm Transformer で、幅 のヘッド 個()、GPT-2 トークナイザ、文脈長 512 である。routed 対照は幅 64 の 16 ヘッドを 768 次元に書き込み、さらに 2 つの対照は 16 ヘッド 21 層の softmax-free アーキテクチャを使う(付録 A)。訓練は 16,384 トークンのステップを 65,536 回、AdamW(ピーク学習率 を に減衰、weight decay 0.1)で行う。コーパスは FineWeb-Edu(sample-10BT、付録 A)から 2 つ使った。R は訓練を通して復元抽出される 2 億トークン、S は一度だけ読まれる 10.7 億トークンである。全モデルは 1 つの検証セットを共有し、比較はコーパス内で行う。凍結基底は訓練しない。 を座標ブロック の埋め込みとし、 を Kerdock 集合から構築した凍結直交行列(異なる基底のブロック間で )とすると、ヘッド の回転書き込みは 、回転基底のブロック である(構築・メンバー割当・スケールは付録 C)。モデル名は凍結されたものの層間の性質を表す。どちら側を凍結するか(write、read、all)と、凍結部分空間が全層で common か層ごとに rotated かである。*なぜ rotated か。*どちらの設計でも 1 層のヘッドは単一の正規直交基底の異なるブロックを受け取るので、層内のヘッドは常に直交する。変えるのは層同士の関係である。全層で同じ基底を使う(common)と、各ヘッドの部分空間は他の層の同一インデックスのヘッドとだけ overlap する(その相手とは 、残りとは 0)。基底を層ごとに異なる直交行列 で回転させると、その overlap は他の層のすべてのヘッドに近似的に均等に(どの対も 、、等方値)広がる。2 つの名前はこうして、固定量の層間 overlap の配分の両極を表す(命題 1)。本文で使うモデルを表 2 に、その書き込み幾何を図 1 に示し、全 21 構成とそのタスク性能を付録 A に挙げる。
| モデル | 書き込み | 読み手 | コーパス | パラメータ | 検証損失 | |
|---|---|---|---|---|---|---|
learned |
学習 | 自由 | R | 124.05M | 3.604 | --- |
write-common-axis |
(全層) | 自由 | R | 116.97M | 3.643 | |
write-common |
(全層) | 自由 | R | 116.97M | 3.648 | |
write-rotated |
(層ごとに 1 基底) | 自由 | R | 116.97M | 3.654 | |
learned |
学習 | 自由 | S | 124.05M | 3.508 | --- |
write-rotated |
自由 | S | 116.97M | 3.563 | ||
read-common |
学習 | ブロック | S | 104.58M | 3.610 | |
all-common-axis |
ブロック | S | 97.50M | 3.698 | ||
all-rotated |
別基底のブロック | S | 97.50M | 3.751 | ||
all-rotated-self |
のブロック | S | 97.50M | 3.753 |
表 2. 本文で使うモデル。「自由」読み手は通常の学習される 。「ブロック」読み手はヘッドごとの LayerNorm の後に 写像を 1 つの残差ブロック(Q・K・V で同じブロック)に適用する。 は学習写像の初期出力 RMS に合わせた固定スケール。検証損失は nat 単位、 は同一コーパスの learned に対する差(丸め前の損失から計算)。各 1 シード。ただし learned と write-common-axis はコーパス R で 2 シード(s42 を表示)。
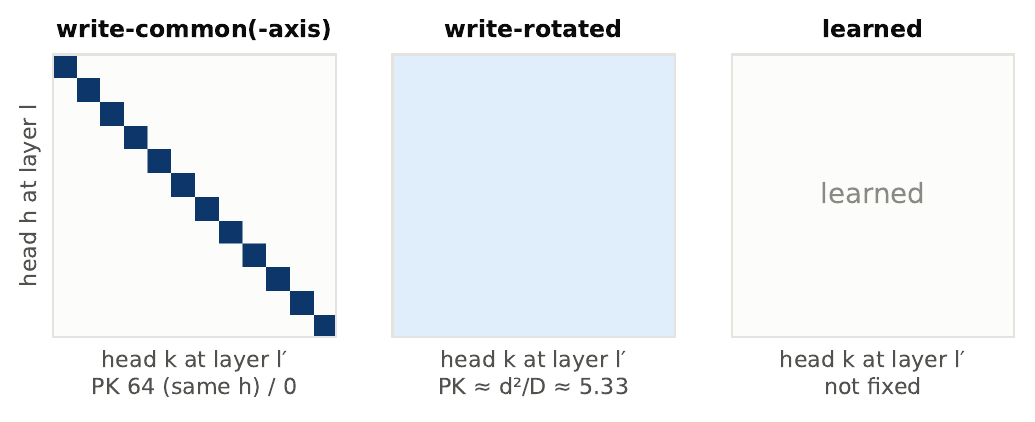
図 1. 設計された書き込みの層間幾何(重み空間): 層 のヘッド の書き込み空間と層 のヘッド の書き込み空間の PK。all-common-axis では共有書き込みがブロック読み手と組み合わされ、各ヘッドは自分のレーンだけを読み書きする。その重み空間の読み書き PK は同一インデックスで 64、それ以外で 0。ヘッドごとの LayerNorm の中心化を折り込むと読み手は高々 63 次元になるが、他のレーンとは依然直交する。all-rotated はすべての層間読み書き PK を約 5.33 にする。
タスク。 各タスクは 2 値の次トークン選択である。clean プロンプトと参照プロンプトは同じ長さで 1 トークンだけ異なる。各タスクは 4 つの均衡条件と互いに素な語彙分割を持つ。discovery 300、validation 240、evaluation 240、holdout 32 例である。SVA では The [subject] [prep.] the [attractor] is/are で、参照プロンプトは主語の数を反転する。Quote では prefix = "red"\n note = ’blanket poem ’ か " で、参照プロンプトは対象の開き引用符を入れ替える。Plural では She bought two cats and one small red cat/cats で、参照プロンプトは 2 つ目の数詞を反転する。2 つの形容詞が数の情報を attention 経由に強制する。すべてのモデルは介入前にすべてのタスクを解く(evaluation 正解率 85.8–100%、付録 A)が、clean なロジットマージンは異なり、これが 5.2 節で重要になる。
介入と指標。 ヘッドの出力を の直前で、全位置で、参照プロンプトでの値に置き換え、正解−不正解のロジット差の低下 を記録する。例について符号付きで平均し、絶対値は平均の後に取る。 として、有効ヘッド数は であり、 とともに報告する。 は別々の単一ヘッド介入の絶対効果の和であり、同時介入の効果でもモデルの総効果の分解でもない。層をまたいでインデックスを共有するヘッドをレーンと呼ぶ。共有書き込みモデルではレーンは 1 つの書き込み空間に対応するが、それ以外ではインデックスは層間で共有される幾何的意味を持たない。 として、レーンスコア
は層間の効果の質量のうち同一インデックス対にあるものの割合である(チャンス )。その 値は各層内でヘッドラベルをシャッフルして得る(5,000 回)。各分析が使う分割と正確なクランプ条件は付録 C に挙げる。
5 Results
5.1 ヘッドへの介入は幾何的に排他的でなく、重要なヘッド間では最も排他的でない
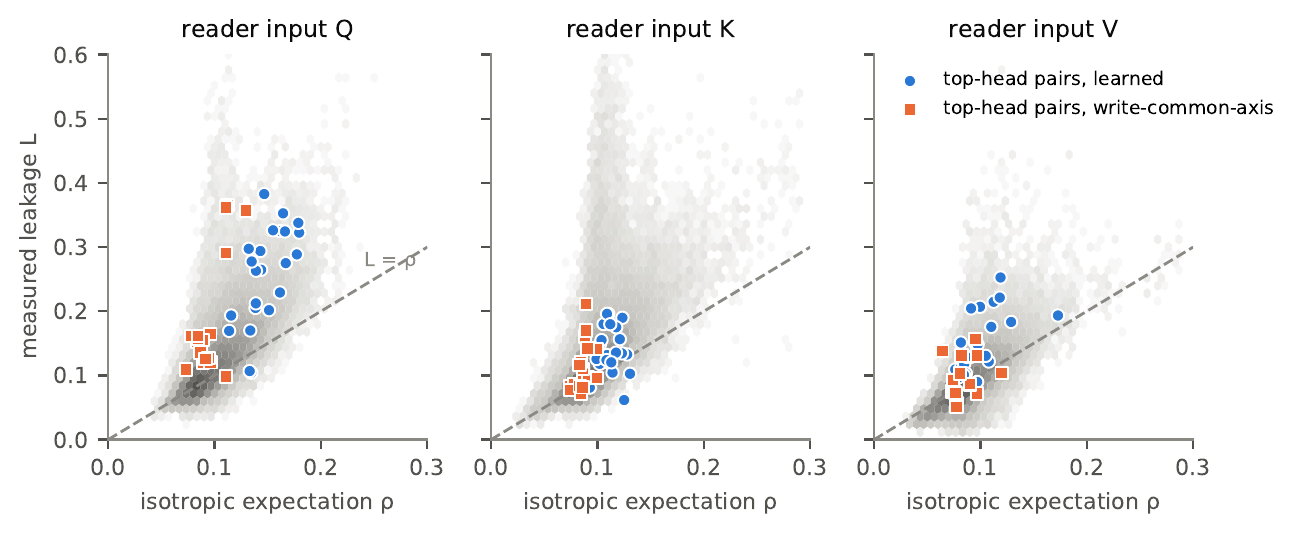
図 2. 実際のパッチ摂動の folded 読み取り空間への測定された leakage を、その等方期待値 に対してプロットしたもの。すべての源ヘッド 後続読み手の対(灰色の密度、5 モデル・3 タスク)と、各タスクの上位 3 ヘッド間の対(色付き)。典型的な対は部分空間の幾何の予測とほぼ同じだけ leak する。タスクに関与するヘッドの対はそれ以上に leak し、後のヘッドの query への leakage が最も強い。
実際のパッチ摂動 の、後続のすべてのヘッドの folded Q・K・V 読み取り空間への方向的 leakage を測定した。5 つのモデル(learned: コーパス R で 2 シードと S で 1 つ、write-common-axis: 2 シード)、3 タスク、各 240 例である。再計算したパッチ効果は保存されたヘッドパッチの結果と 以内で一致する。各対について実際の応答も測った。 単独が引き起こす読み手入力の正確な変化(direct 経路)と、パッチされた順伝播全体による変化(total)である。
*すべての介入は後続のすべてのヘッドの読み取り空間に射影される。*典型的な源−読み手の対は摂動のエネルギーの 8–12% を受け取り、これは部分空間の予測に近い( の中央値は learned モデルで Q と K が 1.09–1.13、V が 0.95–0.97、write-common-axis で 1.02–1.05 と 0.97)。対にわたって、leakage は等方期待値を追う(Spearman は learned モデルで 0.73–0.81、write-common-axis で 0.46–0.72)。これらのモデルのヘッド単位のパッチはどれも幾何的に排他的でない。その摂動は、ほぼ幾何の定めるとおりに、後続のすべてのヘッドの読み取り空間に広がっている。
タスクに関与するヘッドは互いの query に、幾何の予測以上に leak する(図 2)。各タスクの上位 3 ヘッド間の 40 の順序対について、後のヘッドの query への leakage は全後続読み手の中で百分位の中央値 97.6 を持つ。これらの対の 85% は第 90 百分位より上にあり、中央値で等方期待値の である。この濃縮は V(、百分位 90)と K(、百分位 77)では弱い。層位置の効果ではない。同じ 2 層間の対とだけ比較しても、上位ヘッド間の query leakage は依然百分位の中央値 97 を持ち、78% の対が第 90 百分位より上で、learned(97)でも write-common-axis(96)でも同様である。V の濃縮は learned モデルでは保たれる(百分位 95)が write-common-axis では保たれない(63)。これらの対では、後のヘッドの入力の direct な変化は total な変化と方向でも大きさでも近く整列している。 と のプールした cosine は中央値で Q が 0.86、K が 0.81、V が 0.83(全対では 0.50–0.53)、ノルム比 は中央値 0.98、0.94、0.88(全対では 0.72–0.80)である。両者の積である射影係数 は中央値 0.84、0.81、0.70(全対では 0.34–0.49)であり、角度とノルムの両方に依存し 1 では抑えられない。40 対は 15 のモデル−タスクの組合せから来ておりヘッドを共有するので、独立なサンプルではない。これらの上位ヘッドは測定と同じ evaluation 分割で選ばれたので、discovery 分割で選んだ上位ヘッド(45 ヘッド中 41 が一致)で分析を繰り返した。層対の中では、query leakage は依然百分位の中央値 97、78% の対が第 90 百分位より上、等方期待値の である。
*この query leakage は後のヘッドの attention 先を変えるのか。*すべての後続ヘッドについて、query だけ、key だけ、両方(direct 経路)、順伝播全体のそれぞれがパッチを運ぶときの、予測位置での attention 分布の変化(全変動、TV)を測った。上位ヘッドの 40 対では、後のヘッドの query だけを摂動する方が key だけを摂動するより attention を大きく変える対が 90% である(TV の中央値 0.029 対 0.014)。これは全後続ヘッドの中央値(0.015)の約 2 倍で、百分位の中央値は 91 である。各源の後続ヘッドにわたって、Q leakage はこの query-only の変化を予測する(45 源での Spearman の中央値 0.41)。順伝播全体では、後続の上位ヘッドの attention は依然変化し、direct 経路よりわずかに大きい(TV の中央値 0.035 対 0.033)。しかし他のすべての後続ヘッドの attention も大きく変わる(中央値 0.032、direct 経路では 0.019)ので、上位対はもはや例外的でない(百分位 66)。ネットワーク全体の応答で弱まるのは相対的な濃縮であって、変化そのものではない。これらの値は attention の質量がどれだけ動くか(数%)を測るものであり、それだけでは行動上の帰結を限定しない。
幾何的な到達は機能的なルーティングと同じではない。5.3 節で調べる同一インデックス対の中では、後の重要ヘッドをクランプすると前のヘッドの出力効果は % から 24% 変わる。異なるインデックスの対では % から 56% の範囲で変わる。重み空間の PK と個々のヘッド間エッジの重要性の関係は付録 B.1 に報告する。
5.2 排他的な overlap の配分はヘッド単位の集中を一貫しては高めなかった
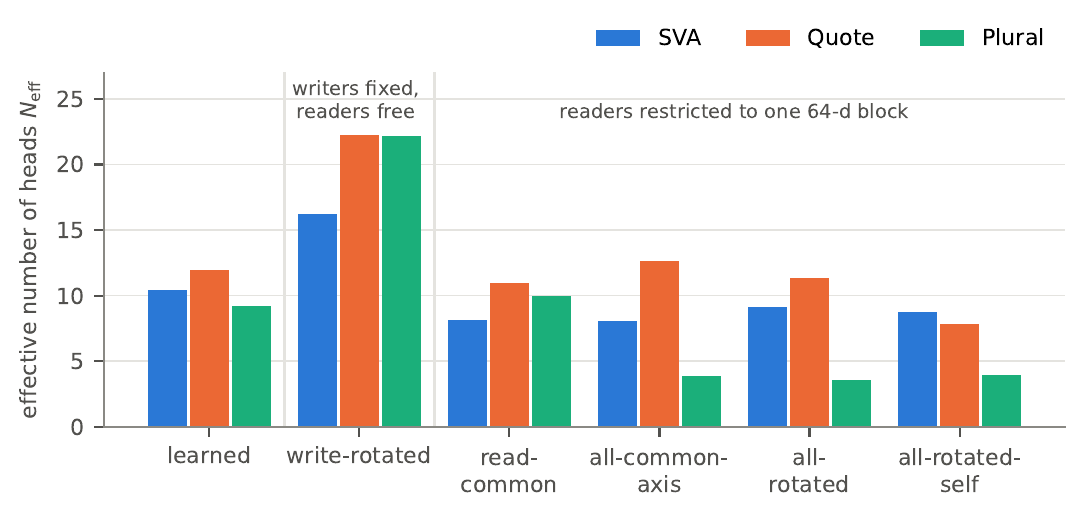
図 3. コーパス S での有効ヘッド数 (低いほど集中)。結合を固定しブロックに制限した 3 モデル(all-common-axis: インデックス間排他、all-rotated と all-rotated-self: 近似一様 PK)は SVA と plural で似た値を持ち、quote では all-rotated-self がより集中している。読み手を自由にしたまま書き込みを凍結すると効果は拡散する。各モデル 1 シード。
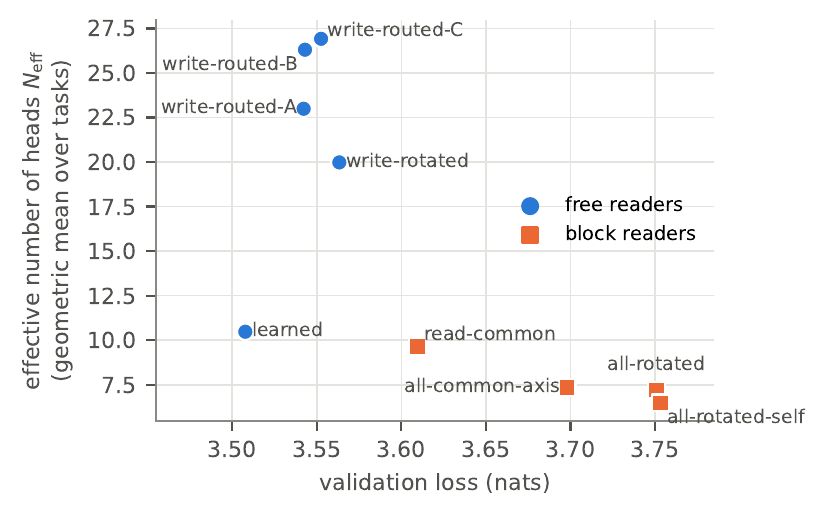
図 4. コーパス S の 9 モデル(16 ヘッドの write-routed 3 モデルを含む)の検証損失と (タスクの幾何平均)。モデルは勾配に沿うのではなく読み手のタイプで 2 つのクラスタに分かれる。これらのコーパス S モデルの中では、ヘッド単位の集中は読み手が制限された所にだけ現れ、それらのモデルはパラメータが最も少なく損失が最も悪い。
all-common-axis と all-rotated は仮説が名指す変数で異なるが、それだけで異なるのではない。all-common-axis は全層で 1 つの基底を使い自分の書き込み部分空間を読むのに対し、all-rotated は基底を層ごとに回転させ別の基底を読む。したがってこの比較は、複数の幾何的性質を同時に変える設計の間の比較である。all-common-axis では、ヘッドの書き込みは同一インデックスのヘッド以外のすべての読み手と直交するので、パッチは MLP を通してしか他のインデックスに届かない。all-rotated では、すべての書き込みが後続のすべての読み手と重み空間で だけ overlap する。ここでの「一様」はこの近似的に一定な PK を指し、同一の主角を指すのではない。仮説は、他の違いがその効果を相殺しないかぎり、all-rotated の方が集中しないと予測する。3 タスクにわたって、ヘッド単位の集中に一貫した差は観察されなかった。 は SVA/quote/plural で all-common-axis が 、all-rotated が である(図 3)。all-rotated-self は先行するすべての書き込みと all-rotated とほぼ同じ重み空間 PK を持つが、各層が自分の書き込み基底を読み、これは主角構造も変える。いくつかの書き込みは次の層の読み手と 3 次元を共有するのに対し、all-rotated の書き込みは後の読み手と方向を共有しない(付録 C)。その は で、その最上位ヘッドは SVA と quote でどのモデルよりも大きい のシェアを担う(5.3 節)。quote の値は all-common-axis より低く(7.9 対 12.7)、排他性の予測と逆である。これらの値は近いか逆方向を向くが、同等性を立証するものではない。各モデルは 1 シードなので、これらの構成のシード変動は不明である。我々が持つシード対は他の構成のものであり、それを限定しない。
ヘッド単位の集中とインデックス単位の集中は別の予測である。インデックス間排他性は、効果を少数のヘッドインデックスに集中させつつ各インデックスの層にまたがって広げ、ヘッド単位の を変えないことがありうる。、 とすると、エントロピーは と正確に分解されるので、、(平均層数ではなく条件付きエントロピーの指数)として である(表 3)。SVA と quote で、all-common-axis は 2.0 と 3.8 インデックスに集中し、これはヘッドインデックスの層内置換が与える値(帰無中央値 5.0 と 5.6、。plural では 2.3 対 2.7)より少なく、インデックス内では 4.0 と 3.3 層に広がり、これは all-rotated、all-rotated-self、learned(1.7–2.1)より多い。似たヘッド単位の値はこうして異なる構造を隠す。all-rotated と all-rotated-self はインデックス単位ではチャンスである()。このパターンは 1 つの設計に固有ではない。MLP を learned のパラメータ数まで広げたコーパス S の write-common-axis モデルである mlp3456 は SVA と quote でそれを示す( と 、インデックス単位 )が、幅 384 の value アダプタで容量を補償する value384 は quote でインデックス単位の有意性に届かない()。共有書き込みを持たないモデルも一部を示す。読み取りブロックを共有し書き込みを学習する read-common は SVA で少数のインデックスに集中し(3.6、)、write-rotated はインデックスあたり 2.6–3.3 層に広がり quote で少数のインデックスに集中する()。これらのインデックス単位の検定はモデル間で補正していない。all-common-axis では、インデックス間排他性・インデックス内で共有された書き込み空間・インデックス内で共有された読み取りブロックが構成上一致するので、そのインデックス単位の集中をどれか 1 つに帰属させることはできない。
| モデル | SVA | Quote | Plural |
|---|---|---|---|
learned |
|||
write-rotated |
|||
read-common |
|||
all-common-axis |
|||
all-rotated |
|||
all-rotated-self |
|||
write-common-axis (mlp3456) |
|||
| による | |||
learned |
20.1 | 18.8 | 24.0 |
write-rotated |
25.3 | 34.8 | 40.1 |
read-common |
14.8 | 16.1 | 21.0 |
all-common-axis |
11.9 | 18.7 | 9.1 |
all-rotated |
13.8 | 17.4 | 8.3 |
all-rotated-self |
13.0 | 12.7 | 9.0 |
write-common-axis (mlp3456) |
19.0 | 34.4 | 28.7 |
表 3. ヘッド単位の の、有効ヘッドインデックス数とインデックス内有効層数への分解 (コーパス S、evaluation 分割)。最後のブロックは平均後でなく例ごとに絶対値を取った による 。各値は別々に丸めているので、表示された因数の積は正確に一致するとは限らない。
の推定方法に関して 3 つのチェックを行った(付録 C)。第一に、絶対値は例についての平均の後に取るので、ある例では役立ち別の例では害するヘッドは小さい重みしか得ない。例ごとに先に絶対値を取ると は 1.4–3.0 倍に上がり、モデルの相対順序はおおむね保たれる(全 57 のモデル−タスクで Spearman 0.95、図 3 のコーパス S の 6 モデルの中では 0.83–0.94)が、いくつかの接戦は逆転する(plural の learned 対 read-common、quote の learned 対 all-common-axis)。書き込みと読み手の両方を凍結した 3 モデルではパターンは変わらない(表 3)。第二に、両モデルで同じ evaluation 例を再抽出する の差のペアブートストラップ区間(95%)は、SVA では all-common-axis が all-rotated と all-rotated-self より集中し( [, ] と [, ])、quote では集中せず( [, ] と [, ])、plural では解決しない( [, ] と [, ])ことを示す。各タスクの 4 つの均衡条件の中では、all-common-axis が all-rotated より集中しているのは SVA、quote、plural でそれぞれ 4 条件中 3、2、1 である。第三に、evaluation 例は少数の語彙グループ(SVA は 4 つの主語名詞対、quote は 8 つの変数名、plural は 24 の名詞)から来る。どの 1 グループを除いてもどのモデルの も 9% を超えて変わらず、all-rotated-self との未解決の plural 比較以外、これらの差を逆転させない。これらのチェックは evaluation の語彙とテンプレートを条件とするものであり、新しい語彙への汎化もシード変動も扱わない。
幾何の固定が一般に機能を集中させるわけでもない。learned と同じ層あたり 12 ヘッドで、write-rotated(書き込み凍結・読み手自由)は 3 タスクすべてでより大きい を持ち( 対 、倍率 1.6、1.9、2.4)、 は同程度である。差のペアブートストラップ区間は [, ]、 [, ]、 [, ] で、どの語彙グループも逆転させない。2 つのモデルはパラメータ数(116.97M 対 124.05M)と検証損失( nat)でも異なるので、この比較は書き込み幾何だけの比較ではない。各倍率はコーパス R の learned の 2 シード間の比(1.3、1.3、2.2。唯一の学習書き込みのシード対)を超える。これは他の構成のシード変動を示唆するが限定はしない。3 つの write-routed モデルも同じ方向を向く(9 比較すべてで倍率 1.7–3.3)が、層あたり 16 ヘッドなので候補ヘッド数が異なり、生の 比較は交絡する。これらは補助的な証拠として扱う。この方向はコーパス R の write-common-axis にも現れ、そこでは各モデル 2 シードがシードレベルの比較を許す。quote では、そのどちらのシードも両方の learned シードの 1.6–2.1 倍のヘッドに効果を広げる( と 対 と )。SVA と plural ではシードが重なる(、 対 、、および 、 対 、)。
コーパス S では、ヘッド単位の は読み手制限モデルの 12 のモデル−タスク比較のうち 10 で learned を下回り、write-rotated の 3 比較では 1 つも下回らなかった。これはコーパスをまたいで普遍的ではない。コーパス R では、自由読み手の write-common-axis が一部の単独比較(plural、シード 42: 9.4 対 13.3、SVA、シード 43: 11.2 対 12.7)で learned を下回るが、安定した効果とは見なさない。書き込みと読み手の両方を凍結した 97.5M の 3 モデルでは、ヘッド単位の集中は plural で最も強く、1 つのヘッドが絶対効果の 77–78% を担う。read-common では plural の最上位ヘッドは 28% を担う。それを読み手の制限そのものに帰属させない理由を図 4 が示す。集中したモデルは、パラメータが最も少なく、損失が最も高く、clean な plural マージンが最も小さい(ロジット差 2.30–2.54、learned の 3.10 と read-common の 3.14 に対して)モデルでもある。plural では、学習された書き込みを保つ読み手制限モデル(read-common、104.6M、 nat)は集中しない( 対 learned の 9.2)が、97.5M の 3 モデル( から )は集中する。図 4 のコーパス S の 9 モデルにわたる損失と の順位相関(、12 ヘッドの 6 モデルでは )は 2 つのクラスタを反映するものであり、漸進的な関係ではない。現在のモデルでは、読み手の制限を、容量の低下や弱いタスク性能から分離できない。
関連する 2 つの分析を付録 B に報告する。座標単位の集中はそれを測る表現に強く依存し(付録 B.2)、制約されたモデルでは上位ヘッドの効果の direct 経路が小さい(付録 B.3)。
5.3 共有された書き込み空間はヘッドをレーンに整列させる
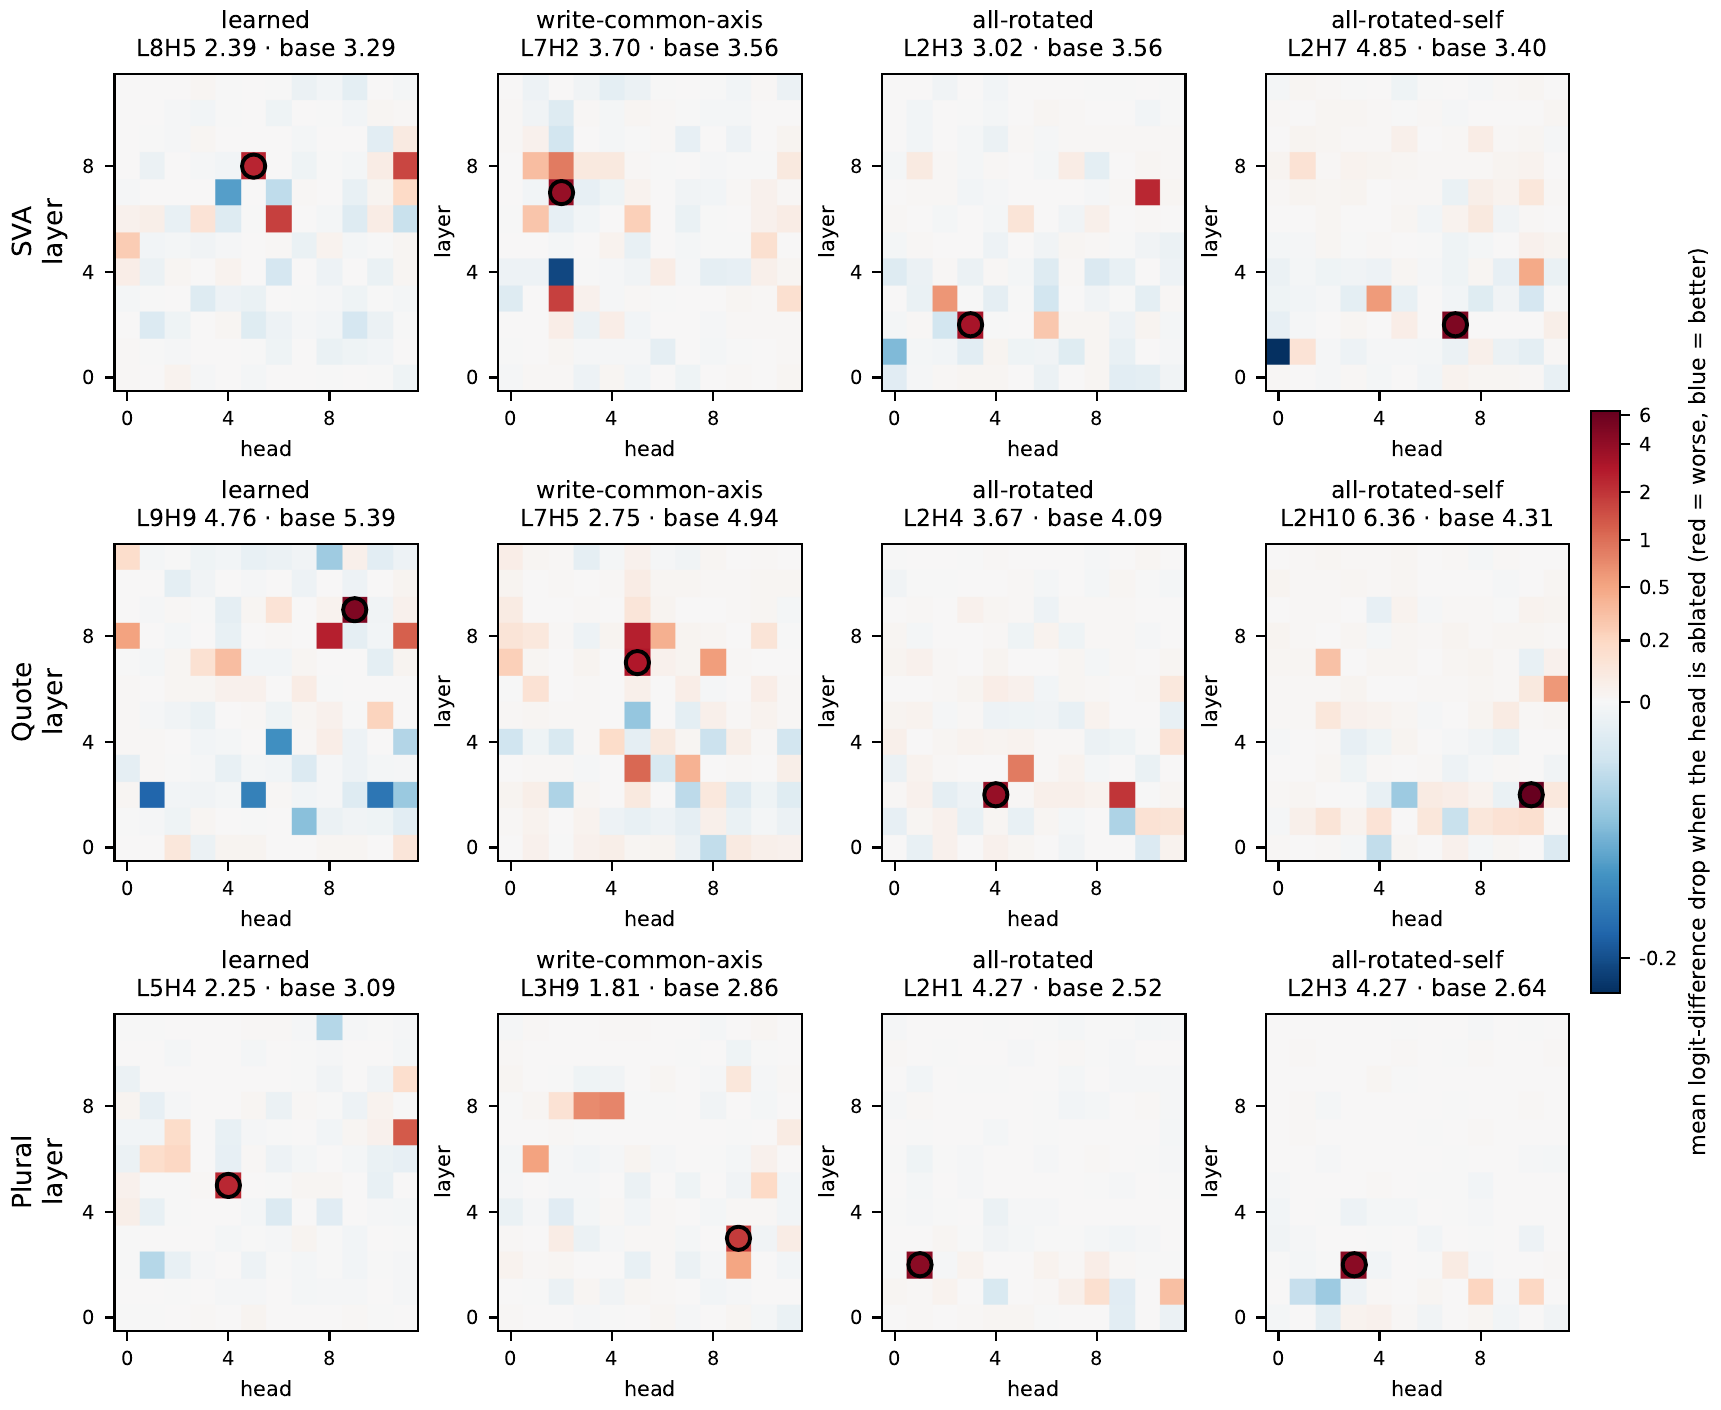
図 5. 1 ヘッドをパッチしたときのロジット差の平均低下(discovery 分割、層 0 が下)、コーパス S で訓練した 4 モデル。write-common-axis は MLP を learned のパラメータ数に合わせて広げた変種(mlp3456)で、どちらも自由読み手。all-rotated と all-rotated-self は書き込みと読み手を層ごとに回転した基底に凍結し、層がどの基底を読むかで異なり、これは主角構造も変える(付録 C)。赤: パッチが害する。青: 役立つ。色は全パネル共通の スケール。丸と見出しは最大低下のヘッドとパッチ前のロジット差(base)。書き込み空間が共有されると、重要なヘッドは 1 つの列に積み上がる。write-common-axis の上位 3 ヘッドは SVA ですべてインデックス 2、quote ですべてインデックス 5 である(、、、、チャンス )。learned は 。plural は有意なレーンを示さない。回転モデルは同一インデックスのレーンを作らない()が、効果の最大シェアを 1 つのヘッドに置く( の 39–78% と 61–77%、learned は 34–45%、5.2 節)。この集中は同一インデックスのレーンではなく、他の層のすべてのヘッドと近似一様な PK を持つ all-rotated にも現れるので、インデックス間排他的な結合に由来するものではない。
幾何は重要なヘッドの組織を変える。図 5 はコーパス S で訓練した 4 モデルを示す。learned、MLP を広げてパラメータを合わせた write-common-axis 変種、書き込みと読み手の両方を層ごとに回転した基底に凍結した 2 モデルである。ヘッドインデックスがすべての層で 1 つの書き込み空間を保つと、タスクに重要なヘッドは同じインデックスに積み上がる。図 5 のパラメータを合わせた write-common-axis モデルでは、上位 3 ヘッドは SVA ですべてインデックス 2、quote ですべてインデックス 5 であり( と 、 と )、もう 1 つの容量補償変種(value384)は強い SVA レーンを持つ(、)。書き込み空間と読み取りブロックの両方を層間で共有する all-common-axis は観察された中で最も強いレーンを持ち(SVA と quote で と 、 と 、plural で )、読み取りブロックだけを共有する read-common は持たない(、)。効果はコーパス R でも再現する。write-common は SVA/quote/plural で ()、write-common-axis は ()である。書き込みが学習されるか層ごとに回転されるモデルは同一インデックスのレーンを示さない。learned(3 つの learned モデルすべてで 、)、write-rotated(–、)、all-rotated(–、)、all-rotated-self(–、)。これらのモデルではヘッドインデックスは層間で共有される幾何的意味を持たないので、これは効果が所与のインデックスに沿って集中しないと言うだけであり、異なるインデックスを層間で結ぶ機能的な連鎖を排除しない。それを検定するには discovery 分割で層間対応を推定し別の分割で評価する必要がある。それでも all-rotated-self はどのモデルよりも効果を単一のヘッドに集中させる。その最上位ヘッドは SVA と quote で単一ヘッド効果の絶対値和 の 61% と 64% を担い、ヘッド評価データのある 19 構成の中で最大のシェアである(3 つの learned モデルでは 27–37%)。plural では 77% を担う(42–62% に対して)。SVA と quote での差は少なくとも 24 ポイントである。参考までに、SVA と quote で learned と write-common-axis のシードは高々 9 ポイントしか違わないが、これはこの構成のシード変動を限定しない。そのシェアは、同じパラメータ数と検証損失(3.751 対 3.753)を持つ all-rotated(42% と 39%)も超える。plural では 2 つの回転モデルは同等に集中する(77% と 78%)。2 つのモデルは各層が読む基底で異なり、それとともに 2 つの幾何的性質で異なる。all-rotated-self の各ヘッドは自分の書き込み部分空間を読み、その書き込みのいくつかは次の層の読み手と 3 次元を共有する(付録 C)。この比較はこれらを分離しない。1 つのヘッドへの集中とレーンへの整列はこうして別個の性質である。自己読み取りのある設計では、同一インデックスのレーンなしに、SVA と quote でより大きい最上位ヘッドのシェアが観察された。SVA では、上位 3 ヘッドの中のインデックスの繰り返しは、訓練した 7 つの write-common-axis 変種(2 シード、制限対角書き込み、2 つの容量補償モデル、スケールなし変種、softmax-free アーキテクチャ)のすべてに現れ、4 つの learned モデルには 1 つも現れない。座標軸との整列は必要ではない。回転した共有書き込み(write-common)もレーンを作るからである。各検定はモデル内の置換検定で、そのモデルの 3 タスクについて補正している。調べたモデル間では補正しておらず、以下のリストはレーンスコアを報告するすべての共有書き込みモデルである。この補正の後、SVA レーンは write-common()、パラメータを合わせた write-common-axis(、quote )、value384()、all-common-axis(、quote )で有意に残るが、コーパス R の write-common-axis(、quote )では残らない。これらは構成間の観察であり、シード間の再現ではない。コーパス R の write-common-axis は 2 シードあり、どちらも上位 3 の SVA ヘッドにインデックスの繰り返しを示すが、レーンスコアはシード 42 でのみ計算した。他のすべての構成は 1 シードである。レーンはこうして、両コーパスの複数の独立に訓練された共有書き込み構成にわたって観察され、SVA で最も明瞭、quote と plural ではより弱い。一方、1 つの構成のシード間での安定性は検定されていない。
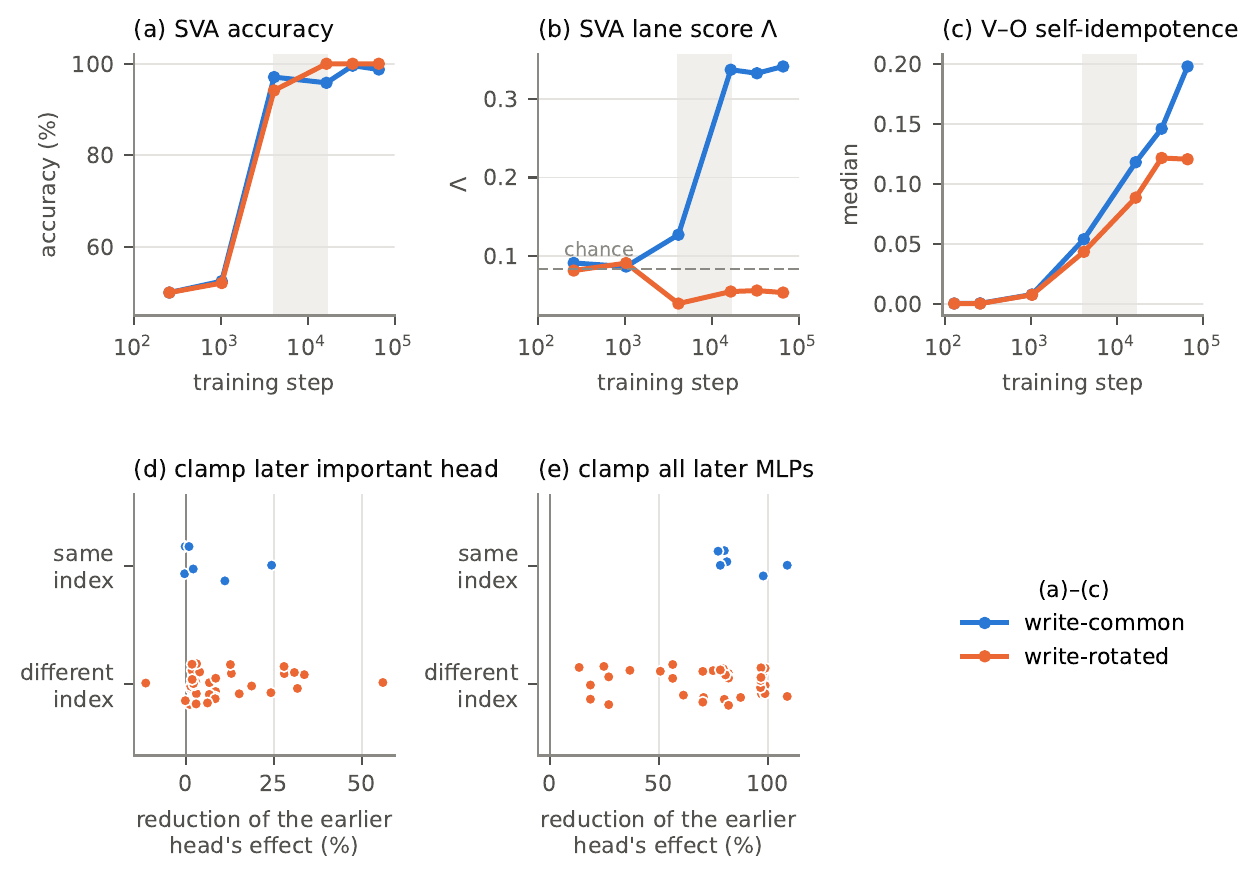
図 6. (a)–(c) 訓練中の SVA 正解率、レーンスコア、V–O 自己 idempotence。両モデルはステップ 4,096 までに の正解率に達する。write-common のレーンはステップ 4,096 から 16,384 の間にだけ形成される(網掛け)。(d)–(e) 後の重要ヘッド (d) または後のすべての MLP (e) を clean 値にクランプしたときの、前の重要ヘッドの効果の低下(クランプなしの効果に対する割合)、5 モデル・3 タスクの上位 3 ヘッドのすべての順序対。同一インデックス対(青)は他の対より大きい低下を示さない。
レーンが何であるかを制約する 3 つの観察がある(図 6)。第一に、レーンはタスクに必要ではない。write-common はステップ 4,096 で既に SVA を 97% で解いており、そのとき ()である。write-rotated はレーンを作ることなく 100% に達する。
第二に、調べた対の中では、同一インデックス対はリレーとして選好されない。図 6 の 5 モデル分析の上位 3 対の中で、同一インデックス対は write-common と write-common-axis にだけ現れる。後の同一インデックスの重要ヘッドを clean 値にクランプすると、前のヘッドの効果は % から 24% 変わる(例えば write-common-axis の L5H4 L8H4 で 0.9%)。異なるインデックスの重要ヘッドのクランプでは % から 56% 変わる。後のすべての MLP のクランプは、3 つの凍結書き込みモデルで 70–109%、learned で 13–97% 減らす。クランプによる減少はクランプした部品を通る流れではない。クランプはネットワークの残りと相互作用し、いくつかの減少は負である(例えば同一インデックス対で と 、異インデックス対で )。調べた対の中では、同一インデックス対は概して選好されなかった。後のヘッドを 1 つクランプするだけでは、複数のヘッドに冗長に広がったリレーを排除できない。レーン全体の一括クランプがより強い検定である。all-common-axis の別の分析では、源ヘッドとインデックスを共有する後のすべてのヘッドを一度にクランプする(MLP を通る経路は含まれる)。唯一の例外は SVA である。このクランプは上位 5 ヘッドの効果の合計を 21% 減らす(他のインデックスでは 0.6%)。quote()と plural()にはそのような効果はない。
第三に、レーンは共有されたタスク感受性と一致する。evaluation 例での SVA ロジット差の、層 の attention 出力に関する勾配 を取る。これは各層の書き込みにタスク出力がどう応答するかを測るものであり、訓練が従う言語モデリング勾配ではない。これらのタスク勾配は層間で似ている(隣接層間の cosine 0.79–0.89)。同一インデックスのヘッドの書き込み空間に射影すると、 と の cosine は write-common で 0.45–0.63、write-rotated で 0.04–0.05 である。この射影 cosine は幾何そのものにも依存する。2 つの書き込み空間が異なれば同一の でも小さくなるので、この対比は訓練が生んだ整列の独立な証拠ではない。タスク勾配は、ヘッドが整列する前に、最終的なレーンに集中してもいる(手順は付録 C)。
測定された事実は、レーンはタスクが解けた後に形成されること、調べた対の中で同一インデックスのヘッドはリレーとして選好されないこと、同一インデックスのヘッドは射影されたタスク感受性を共有することである。これらと整合する 1 つの説明は、共有された書き込み空間が共有された勾配アドレスとして働き、同一インデックスのヘッドが似た訓練信号を受け取り、似た役割へと訓練されるというものである。この事実は、共有された感受性からレーンを形成する共有された訓練信号への段階を立証しない。我々が測ったのは言語モデリング勾配ではなくタスク感受性であり、射影 cosine は部分的に幾何で固定され、同一レーンのヘッドが同じ方向を書くことは示していない。この説明を識別する介入は、ヘッドインデックスの半分だけが層間で書き込みを共有するモデルである。この説明は共有されたインデックスにだけレーンを予測する(第 7 節)。
5.4 value の読み書き自己整列は評価したすべての自由読み手モデルで生じる
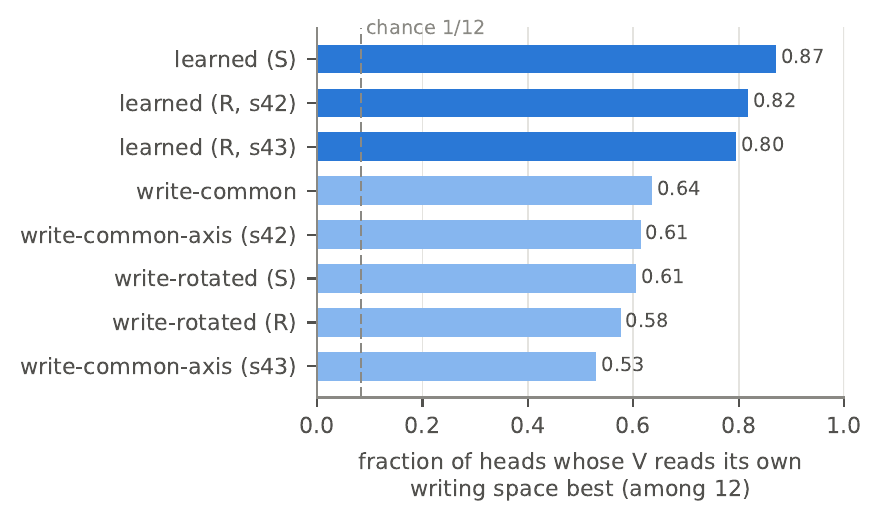
図 7. 層 1–11(先行層の書き込みも持つ層、元の分析の読み手集合。層 0 では、チェックした 6 モデルすべてで 12 ヘッド全部が自分の書き込み空間を最もよく読む)のヘッドのうち、V 読み取り空間(重み空間)がその層の 12 ヘッドの中で自分の書き込み空間と最も強く overlap するものの割合、自由読み手の 8 モデル。
評価した 8 つの自由読み手モデルすべて(図 7)で、ヘッドの重み空間 V 読み取り空間は自分の書き込み空間と整列している。53–87% のヘッドが自分の書き込み空間を最もよく読む(チャンスレベルは 8%)。all-common-axis と all-rotated-self では読み取り空間は設計上書き込み空間と一致し、all-rotated では overlap が近似的に一様値に設定されている。read-common は書き込みを学習するので整列は設計で固定されない。これは評価しなかった。正規化された自己 PK を と書く。整列は学習された書き込みで最も強く(正規化自己 PK – 対 –)、どこでもチャンス()を超えるが完全な overlap には遠い。Feng and Li (2026) の scaled-idempotence 統計量は別の測定である。それは部分空間の間の overlap ではなく、部分空間の中での OV 写像の向きに関わる。モデル間では、その傾向は計算した 5 モデルで自己整列の傾向と一致する。中央値は学習された書き込み(両コーパスの learned)で 0.49–0.52、凍結された書き込み(write-common、write-rotated、write-common-axis シード 42)で 0.12–0.22 である。過程を追える凍結書き込みモデル write-common と write-rotated では、整列は訓練の初期に形成される。自分の書き込み空間を最もよく読むヘッドの割合はステップ 256 でチャンス(0.09 と 0.08)、ステップ 1,024 で 0.11 と 0.13、ステップ 4,096(訓練の約 6%)で 0.56 と 0.54 であり、最終では 0.64 と 0.58 である。勾配はそれ以前に自分のブロックを選好する。初期化時には、ヘッドの V 勾配のスカラー(トレース)成分が自分のブロックで他の 11 ブロックのそれぞれを絶対値で超えるのは 6–7% のヘッドで、チャンスである(手順は付録 C)。ステップ 256 までに 77–78% で超える。これは AdamW 前の生の損失勾配を絶対値で比較したものであり、勾配が自分のブロックのスカラー方向を早期に選好することを示すが、更新の符号やブロックの非スカラー部分に対する大きさは示さない。最終重みではスカラー部分は浅い層で負、深い層で正であり、Trockman and Kolter (2023) の訓練済み OV 積と同様である。幾何の制約はこの整列を生み出すものではない。
6 Discussion
読み書き幾何が制御するもの、しないもの。 我々の実験は、幾何的排他性・機能的集中・基底集中・組織的整列をヘッド単位の効果の解釈に交換可能に使えないことを示す。幾何は attention レベルの排他性を制御し、これは(重み空間で)設計により正確に設定できる。座標単位の集中はそれを測る表現と介入方向に依存する。1 つのモデルの中では、各ヘッド内の直交回転は 1–8 ポイントしか変えなかったので、大きな差は表現とモデルの間に生じている。幾何は、どのヘッドが書き込み空間を共有するかを通して、組織を形づくる。我々の比較では、単一ヘッドパッチ効果のヘッド単位の集中への幾何の効果を容量から分離できなかった。ヘッドインデックスのレベルでは、パラメータを合わせた共有書き込みモデルも SVA と quote で効果を集中させた。非直交な結合を取り除けばヘッド単位の効果が集中するという仮説は、幾何的排他性と機能的集中の間の関係を予測するが、我々の比較はそれを一貫しては支持しない。書き込み・正規化・容量を揃えたときに幾何が機能的特異性を制限するかは未検証のままである。分離可能な部分計算といったより強い意味でのモジュール性に幾何が影響するかは、我々の測定が扱わない問いである。
保存則が説明するもの、しないもの。 命題 1 は我々の設計が操作する幾何的量を記述する。書き込みが残差ストリームを直交分解するとき、読み手が先行層の書き込みから受け取る overlap の総量は に固定される。したがって排他的な設計は overlap を除去しない。1 つの相手、同一インデックスのヘッドにそれを集中させるのであり、一様な設計は同じ総量をすべてのヘッドに広げる。排他性が変えるのは誰と overlap するかであって、どれだけではない。命題は、配分の変化が訓練や効果の集中にどう影響するかについては何も言わない。その関係は経験的である。我々の比較では、読み手を制限した排他的配分と一様配分のヘッド単位の はわずかしか違わず、タスクによって逆方向だった(all-common-axis と all-rotated、5.2 節)。別に、書き込み空間を層間で共有して書き込み間 overlap を同一インデックスに配分すると、タスク関与ヘッドはレーンに整列した(5.3 節)。これらのモデルは自由読み手なので、これは共有された書き込みについての観察であり、読み書き排他性の検定ではない。
ヘッド単位の集中は別の変数に従う。コーパス S では、それは各ヘッドの読み手が固定の 64 次元部分空間に制限された所に現れ、そこではその部分空間が排他的でも(all-common-axis)、他層のすべてのヘッドと一様に overlap しても(all-rotated)、自分の書き込み空間と一致しても(all-rotated-self、最大の単一ヘッドシェア)現れる。これらのモデルはまた、パラメータが最も少なく(124.05M に対して 97.50M)、検証損失が最も高く( から nat)、quote と plural の clean マージンが小さい。書き込みだけの凍結は損失をほとんど増やさず( から nat)、代わりに効果を広げる(5.2 節)。整合的な説明は、各ヘッドが読めるものを制限すると、計算の独立な部分に寄与できるヘッドの数が制限され、訓練された解が少数のヘッドに依存する、というものである。この説明では、ヘッド間チャネルの排他性ではなく、容量と読み手制約が単一ヘッド効果の集中を決める。この説明は仮説である。読み手制約・パラメータ数・タスクマージンは我々のモデルで一緒に変わっており、パラメータを合わせて補償した読み手制限モデルがそれらを分離するだろう(第 7 節)。
2 つの候補的組織原理。 結果の多くと整合する 2 つの仮説があるが、どちらも立証されていない。第一は、MLP が残差ミキサーとして働くというものである。ヘッド間チャネルが制約されると direct 経路は縮み、我々の使う帰属順序では効果のより多くが MLP に帰属される。MLP には attention レベルの制約は届かない(両方の順序で成り立つのは write-common-axis のみ、付録 B.3)。クランプによる減少は流れではなく、帰属は順序に依存するので、これは帰属の解釈であって測定された経路ではない。第二は、書き込み空間が勾配アドレスとして働くというものである。レーンは、どのヘッドが通信するかではなく、どのヘッドがタスク感受性を共有するかと一致しており、証拠は相関的である(5.3 節)。
ヘッド単位の介入への含意。 実務には 3 つの帰結を引き出す。第一に、ヘッド単位のステアリングとパッチングの結果は介入部位に関するものである。測定した learned と write-common-axis のモデルでは、ヘッドへのパッチは後続のすべてのヘッドの folded 読み取り空間に成分を持ち、他のタスク関与ヘッドの query で最大である。したがってヘッド排他的なチャネルについての主張には leakage と経路の証拠が要る。第二に、残差座標上の集中は、 の前の同じ測定と比較しないかぎり、機能的集中の証拠として使うべきではない(付録 B.2)。第三に、書き込みが層間で共有されるモデルでは、(層, ヘッド) の対ではなくヘッドインデックスがより自然な分析単位かもしれない。分解した 2 つの共有書き込みモデルでは、SVA と quote の効果は少数のインデックスに集中しつつインデックス内の層に広がる(5.2 節)。レーン全体へのパッチングやアブレーションは明白な次の実験である。
自己読み取りヘッドの value 経路。 が構成上成り立つ所(all-common-axis、all-rotated-self)では、value 経路は正確に分解する。ヘッドごとの正規化 と value バイアス を使って
なので、OV 写像は内容を の外に動かさずに の中で適応させる。自由読み手の identity 書き込みモデルでは、浅い層の自ブロック value 写像のスカラー部分だけを取り除くと、15 比較中 13 で等ノルムのランダム編集よりタスクロジット差が大きく下がる(付録 C)。持続的情報チャネル、すなわち深さ方向に固定されたアドレスは、さらにすべての層で同じ を要し、これは all-common-axis でのみ成り立つ。我々が見つけた唯一の同一インデックスリレーはそこ、SVA にあった(5.3 節)。この仮説は開いたままにする。
7 Limitations
シードとスケール。 ほとんどの構成は 1 シードで、モデルは パラメータを トークンで訓練したものである。単一シードのモデル間の近い値は同等性の証拠ではない。レーンの結果は複数の共有書き込みモデルで再現するが、同じモデルのシードがあれば構成内の変動が分かるだろう。all-rotated-self の単一ヘッド集中も 1 シードに依っている。タスクはテンプレートプロンプトの 3 つの 2 値次トークン選択であり、頑健性チェックは evaluation の語彙を条件とする。より大きい事前学習済みモデル(ヘッド単位ステアリング研究の大半の設定)や自由生成はテストしていない。最も直接的なフォローアップは、書き込み・正規化・パラメータ数を揃え、構成ごとに複数シードで読み取り基底を比較することである。
交絡。 読み手の制限は、パラメータ数・ヘッドごとの正規化・損失・clean タスクマージンと交絡している。パラメータを合わせて補償した読み手制限モデルと、Q・K・V の個別制限がこれらを分離するだろう。
機構。 レーンの勾配アドレス説明は相関的である。ヘッドインデックスの半分だけが層間で書き込みを共有するモデルが、1 つのネットワークの中でそれを検定するだろう。
測定。 は 1 タスクずつの単一ヘッドパッチングを要約するものであり、同時効果や相互作用については何も言わない。自己修復 (McGrath et al., 2023) のような下流の補償も含み、各ヘッドを 1 単位として扱うが、ヘッドは複数の機能的下部構造を含みうる (Ahmad et al., 2025)。 の 値はモデル内置換であり、シードレベルの検定ではない。経路分析は上位ヘッドのみを扱う。逐次クランプは相互作用を順序で割り当てる。再実行できたモデルでは相互作用は総計では小さい(効果の中央値 5%)が、75 のヘッド−タスクのうち 20 で 20% を超えた。leakage・attention・経路分析の上位ヘッドは測定に使う evaluation 分割で選ばれた。leakage については discovery 分割での選択が同じ結果を与える。attention と経路の分析は evaluation で選ばれたヘッドを記述する。leakage は folded 読み取り空間を使い、入力依存のランク 1 LayerNorm 項を省く。leakage は learned と write-common-axis のモデルで測った。書き込みと読み手の両方を凍結するモデル(all-common-axis、all-rotated、all-rotated-self)では設計が重み空間 PK を固定する。書き込みが学習される read-common では固定しない。all-common-axis では、他インデックスの読み手への直接 leakage は正確にゼロである。ブロック読み手は自分のブロックしか見ないからである。回転モデルでは重み空間 PK は近似一様()である。ブロックの 写像とゲインが非退化のとき、その folded 読み取り空間は中心化されたブロック(63 次元)でありゲインに依存しないので、folded leakage は中心化と実際の摂動の方向を通してのみ と異なる。ゲインは代わりに実際の応答に入る。これは測定しなかった。
追加シードと半共有対照は実装済みで計画されている。それぞれが特定の結論を覆しうる。レーン効果(シード)、勾配アドレス説明(半共有)、集中の容量説明(パラメータを合わせた読み手)である。
8 Conclusion
attention ヘッド間の非直交な読み書き結合を取り除くとヘッド単位の介入の効果が集中するか、を我々は問うた。幾何を実験変数として扱うことは、この問いが束ねている性質を分離する。測定した learned と write-common-axis のモデルにおけるヘッドへの介入は幾何的に排他的ではない。その摂動は後続のすべてのヘッドの folded 読み取り空間に射影され、他のタスク関与ヘッドの query に最も強く射影される。attention レベルの排他性は正確に課すことができる。それでも、単一シードの比較の範囲では、ヘッドインデックス間で排他的な結合から集中の一貫した増加は観察されなかった。自分のレーンしか読めないヘッドを持つモデルは、ヘッド対にわたって近似一様な層間読み書き PK を持つモデルより一貫して集中してはいなかった。ヘッドの書き込み先を凍結して読み手を自由にすると、コーパス S の write-rotated(learned と同数のヘッド)で 3 タスクすべてにおいて効果が拡散した。より多くのヘッドを持つ routed モデルも同じ方向を向き、コーパス R では比較は quote でのみ解決する。読み手の制限とともに現れる集中は、容量の低下と弱いタスクマージンと共変する。ヘッドインデックスのレベルでは、SVA と quote で、排他的設計は層内置換に比べて効果を集中させるが、インデックス内ではより多くの層に広げる。このパターンの一部は排他的結合を持たないモデルにも現れる。
幾何が確かに形づくるのは組織である。書き込みが層間で共有されると、タスクに関与するヘッドはレーンに並ぶ。この効果は両コーパスの共有書き込みモデルにわたって再現する。単一ヘッドのクランプは同一インデックスのヘッドをリレーとして選好しなかったが、唯一のレーン一括クランプ(all-common-axis、SVA)は選好を示し、レーンは共有されたタスク感受性と一致する。各層が自分の回転した書き込み基底を読む設計では、同一インデックスのレーンなしに、より大きい最上位ヘッドのシェアが観察された。その設計は層間の主角も変えるので、この比較は自己読み取りを原因として分離しない。value の読み書き自己整列は評価した 8 つの自由読み手モデルすべてで生じ、訓練の初期に形成される。したがって、head-specific な介入は head-exclusive ではなく、テストした構成では、ヘッドをインデックス間で幾何的に排他的にしても効果は一貫しては集中しなかった。調べた設計では、読み書き幾何は、効果の集中よりもヘッドの組織のされ方を明瞭に変えた。
References
A. Ahmad, A. Joshi, A. Modi. Beyond components: singular vector-based interpretability of transformer circuits. NeurIPS, 2025. arXiv:2511.20273.
C. Christensen, L. Amdahl-Culleton, K. Ray, J. Tahir, P. Riechers, A. Shai. When is an attention head a computational unit? Shared circuits despite orthogonal representations. ICML, 2026.
K. Clark, U. Khandelwal, O. Levy, C. D. Manning. What does BERT look at? An analysis of BERT's attention. BlackboxNLP, 2019.
A. Conmy et al. Towards automated circuit discovery for mechanistic interpretability. NeurIPS, 2023.
N. Elhage et al. A mathematical framework for transformer circuits. Transformer Circuits Thread, 2021.
J. Feng, J. Li. Scaled idempotence in transformer attention: paired OV geometry and shared-value algebras. arXiv:2609.01129, 2026.
J. Ferrando, M. R. Costa-jussà. On the similarity of circuits across languages: a case study on the subject-verb agreement task. Findings of EMNLP, 2024.
D. Friedman, A. Wettig, D. Chen. Learning transformer programs. NeurIPS, 2023.
Q.-V. Lai-Dang, T. Kang, S. Son. Adaptive transformer programs: bridging the gap between performance and interpretability in transformers. ICLR, 2025.
J. Li et al. Multi-head attention with disagreement regularization. EMNLP, 2018.
K. Li, O. Patel, F. Viégas, H. Pfister, M. Wattenberg. Inference-time intervention: eliciting truthful answers from a language model. NeurIPS, 2023.
D. Lindner, J. Kramár, S. Farquhar, M. Rahtz, T. McGrath, V. Mikulik. Tracr: compiled transformers as a laboratory for interpretability. NeurIPS, 2023.
A. Makelov, G. Lange, A. Geiger, N. Nanda. Is this the subspace you are looking for? An interpretability illusion for subspace activation patching. ICLR, 2024.
T. McGrath et al. The Hydra effect: emergent self-repair in language model computations. 2023.
J. Merullo, C. Eickhoff, E. Pavlick. Talking heads: understanding inter-layer communication in transformer language models. NeurIPS, 2024.
P. Michel, O. Levy, G. Neubig. Are sixteen heads really better than one? NeurIPS, 2019.
J. Miller, B. Chughtai, W. Saunders. Transformer circuit faithfulness metrics are not robust. COLM, 2024.
T. Muşat. Mechanism and emergence of stacked attention heads in multi-layer transformers. ICLR, 2025.
A. J. Nam et al. Causal head gating: a framework for interpreting roles of attention heads in transformers. NeurIPS, 2025.
C. Olsson et al. In-context learning and induction heads. Transformer Circuits Thread, 2022.
E. Todd et al. Function vectors in large language models. ICLR, 2024.
A. Trockman, J. Z. Kolter. Mimetic initialization of self-attention layers. ICML, 2023.
F. Uehara, K. Santo. Reading and writing subspaces of attention heads are disjoint but overlap non-orthogonally. Manuscript, 2026.
S. Vaidyanathan, D. Arbour, A. Mueller, S. Niekum, D. Jensen. The curse of multiple mediators: hidden interaction effects in activation patching. arXiv:2606.27510, 2026.
E. Voita et al. Analyzing multi-head self-attention: specialized heads do the heavy lifting, the rest can be pruned. ACL, 2019.
K. Wang et al. Interpretability in the wild: a circuit for indirect object identification in GPT-2 small. ICLR, 2023.
H. Yamagiwa et al. Measuring affinity between attention-head weight subspaces via the projection kernel. arXiv:2601.10266, 2026.
H. Yun, T. Kang, K. Jung. Analyzing and controlling inter-head diversity in multi-head attention. Applied Sciences 11(4):1548, 2021.
付録 A. 全構成
| モデル(リポジトリ名) | 書き込み / 読み手 | コーパス | パラメータ | 検証損失 | 使用節 |
|---|---|---|---|---|---|
learned (plain-learned42) |
学習 / 自由 | R | 124.05M | 3.604 | 5.1, 5.2, 5.3, 5.4, B.1, B.2, B.3 |
learned (plain-learned43) |
学習 / 自由 | R | 124.05M | 3.595 | 5.1, 5.2, 5.3, 5.4, B.1, B.2, B.3 |
learned (dense) |
学習 / 自由 | S | 124.05M | 3.508 | 5.1, 5.2, 5.3, 5.4, B.1, B.2, B.3 |
write-common-axis (plain-identity42) |
/ 自由 | R | 116.97M | 3.643 | 5.1, 5.2, 5.3, 5.4, B.1, B.2, B.3 |
write-common-axis (plain-identity43) |
/ 自由 | R | 116.97M | 3.643 | 5.1, 5.2, 5.3, 5.4, B.1, B.2, B.3 |
write-common (common42) |
/ 自由 | R | 116.97M | 3.648 | 5.3, 5.4 |
write-rotated (layered42) |
/ 自由 | R | 116.97M | 3.654 | 5.3, 5.4 |
write-rotated (rotated-m1-42) |
/ 自由 | S | 116.97M | 3.563 | 5.2, 5.3, 5.4, B.1, B.3 |
read-common (headblock-learned42) |
学習 / ブロック | S | 104.58M | 3.610 | 5.2, 5.3, B.1, B.2, B.3 |
all-common-axis (headblock-identity42) |
/ ブロック | S | 97.50M | 3.698 | 5.2, 5.3, B.1, B.2, B.3 |
all-rotated (rotated-m2-42) |
/ 別基底ブロック | S | 97.50M | 3.751 | 5.2, 5.3, B.1, B.3 |
all-rotated-self (rotated-m3-42) |
/ 自基底ブロック | S | 97.50M | 3.753 | 5.2, 5.3, B.1, B.3 |
write-routed A (fixed-sum-hub42) |
routed 1612 / 自由 | S | 124.05M | 3.542 | 5.2, B.1 |
write-routed B (fixed-split-cycle42) |
routed / 自由 | S | 124.05M | 3.543 | 5.2 |
write-routed C (fixed-angle-split42) |
routed / 自由 | S | 124.05M | 3.553 | 5.2 |
| fixeddiag42 | 、64 座標中 51 / 自由 | R | 116.97M | --- | 5.3, B.1, B.2 |
| value384 | + value アダプタ / 自由 | S | 124.05M | --- | 5.2, 5.3, B.1, B.2 |
| mlp3456 | 、広い MLP / 自由 | S | 124.05M | --- | 5.2, 5.3, B.1, B.2 |
| identity-original42 | (スケールなし) / 自由 | R | 116.97M | --- | 5.3, B.1, B.2 |
| multiscreen-identity42 | / 自由(softmax-free、2116) | R | 106.51M | --- | 5.3, B.2 |
| multiscreen-learned42 | 学習 / 自由(softmax-free、2116) | R | 128.53M | --- | 5.3, B.2 |
表 4. 訓練した全 21 構成。プロジェクト文書に記録のない検証損失は --- で示す。「使用節」は各モデルを分析する節・付録小節。タスク性能は表 5 に報告する。
訓練データ。 両コーパスとも HuggingFaceFW/fineweb-edu(構成 sample-10BT、リビジョン 87f09149)を GPT-2 トークナイザでトークン化した。コーパス R は 200,000,000 訓練トークン(SHA-256 3c4fb6d0...)を持ち、訓練はそこから復元抽出する。コーパス S は 1,073,741,825 トークン(SHA-256 e857368b...)を持ち、 の訓練トークンにわたって一度だけ消費される。どちらもデータシード 1729 と同じ 200 万トークンの検証ファイル(SHA-256 3dfd7b63...)を使う。ハッシュは各チェックポイントのマニフェストに記録されている。
| モデル(リポジトリ名) | コーパス | SVA | Quote | Plural |
|---|---|---|---|---|
learned (plain-learned42) |
R | 99.2 / 4.32 | 97.5 / 4.75 | 94.2 / 3.04 |
learned (plain-learned43) |
R | 99.6 / 4.07 | 94.6 / 4.44 | 93.8 / 2.92 |
learned (dense) |
S | 99.6 / 3.49 | 100.0 / 5.50 | 97.1 / 3.10 |
write-common-axis (plain-identity42) |
R | 100.0 / 3.84 | 93.3 / 4.46 | 93.8 / 2.89 |
write-common-axis (plain-identity43) |
R | 100.0 / 3.93 | 90.4 / 4.76 | 90.0 / 2.87 |
write-common (common42) |
R | 98.8 / 4.00 | 92.1 / 5.03 | 92.9 / 2.96 |
write-rotated (layered42) |
R | 100.0 / 3.63 | 96.7 / 4.70 | 90.8 / 2.73 |
write-rotated (rotated-m1-42) |
S | 99.2 / 3.64 | 99.6 / 4.53 | 93.3 / 2.91 |
read-common (headblock-learned42) |
S | 98.3 / 3.62 | 99.6 / 5.49 | 94.6 / 3.14 |
all-common-axis (headblock-identity42) |
S | 100.0 / 3.81 | 99.2 / 4.99 | 92.1 / 2.30 |
all-rotated (rotated-m2-42) |
S | 100.0 / 3.88 | 91.3 / 3.92 | 95.4 / 2.44 |
all-rotated-self (rotated-m3-42) |
S | 98.8 / 3.66 | 93.7 / 4.22 | 93.7 / 2.54 |
write-routed A (fixed-sum-hub42) |
S | 99.6 / 3.45 | 97.1 / 4.20 | 95.4 / 3.06 |
write-routed B (fixed-split-cycle42) |
S | 100.0 / 3.63 | 99.2 / 4.93 | 94.2 / 3.04 |
write-routed C (fixed-angle-split42) |
S | 100.0 / 3.78 | 94.2 / 4.10 | 96.3 / 2.81 |
| fixeddiag42 | R | 99.6 / 3.90 | 90.8 / 4.83 | 92.5 / 3.13 |
| value384 | S | 99.2 / 3.81 | 95.0 / 3.96 | 94.6 / 2.99 |
| mlp3456 | S | 100.0 / 3.68 | 88.3 / 4.78 | 93.8 / 2.79 |
| identity-original42 | R | 99.2 / 3.08 | 97.9 / 4.38 | 92.5 / 2.96 |
| multiscreen-identity42 | R | 97.9 / 3.82 | 93.8 / 4.07 | 85.8 / 2.92 |
| multiscreen-learned42 | R | 95.8 / 3.47 | 87.5 / 4.22 | 92.5 / 3.54 |
表 5. 全 21 構成の clean タスク性能: evaluation 分割(各タスク 240 例)での正解率 (%) / ロジットマージン(正解−不正解)。
| モデル | コーパス | SVA | Quote | Plural | SVA | Quote | Plural |
|---|---|---|---|---|---|---|---|
learned (s42) |
R | 10.0 | 12.8 | 13.3 | 12.7 | 11.4 | 5.1 |
learned (s43) |
R | 12.7 | 16.9 | 6.0 | 9.4 | 10.6 | 6.3 |
write-common-axis (s42) |
R | 17.7 | 27.0 | 9.4 | 9.0 | 10.5 | 6.2 |
write-common-axis (s43) |
R | 11.2 | 26.6 | 17.1 | 9.9 | 11.1 | 5.4 |
learned |
S | 10.4 | 12.0 | 9.2 | 7.9 | 12.5 | 4.9 |
write-rotated |
S | 16.2 | 22.2 | 22.2 | 9.2 | 10.6 | 6.0 |
write-routed A |
S | 18.9 | 31.6 | 20.3 | 8.7 | 10.2 | 5.7 |
write-routed B |
S | 29.1 | 29.0 | 21.6 | 8.8 | 11.3 | 4.8 |
write-routed C |
S | 31.1 | 39.7 | 15.8 | 8.8 | 8.9 | 5.1 |
read-common |
S | 8.1 | 11.0 | 10.0 | 9.3 | 12.4 | 6.2 |
all-common-axis |
S | 8.1 | 12.7 | 3.9 | 9.0 | 9.1 | 5.1 |
all-rotated |
S | 9.1 | 11.4 | 3.6 | 8.2 | 8.1 | 5.3 |
all-rotated-self |
S | 8.8 | 7.9 | 3.9 | 8.8 | 9.9 | 5.3 |
表 6. タスクごとの有効ヘッド数 と単一ヘッド効果の絶対値和 (ロジット単位)、evaluation 分割。
付録 B. 補足結果
B.1 PK とエッジの重要性
15 モデルで単一のヘッド間エッジにパッチを当て、各エッジの重み空間 PK と SVA での KL 効果を相関させた(表 7、手順は付録 C)。全エッジでプールすると、Spearman 相関が明確に正なのは 3 つの learned モデルだけである(–)。読み手と入力を共有するエッジのグループの中では、対応は他でも弱いが皆無ではない。書き込みが学習され読み手が制限された read-common では、プール相関は だが、読み手内中央値は Q・K・V で 、、 であり、V の値は learned の範囲内にある。PK が変動する自由読み手の凍結書き込みモデルでは中央値は小さい( から 0.14)。all-common-axis の相関()は構造的である。すべてのインデックス間エッジは設計上 であり直接効果を運べない。all-rotated と all-rotated-self(エッジ間で PK 5.332–5.336)は除外する。その残差的な PK 変動は、この分析が狙う overlap の差ではなく、意図した一様設計からの逸脱を反映するからである。それらの相関はほぼゼロである。読み手内中央値の有意性は検定しなかった。重み空間 PK がエッジの重要性を最も明確に予測するのは、書き込みと自由読み手が一緒に学習される所である。
| モデル | プール | Q | K | V |
|---|---|---|---|---|
learned(3 モデル) |
0.30–0.32 | 0.46–0.47 | 0.36–0.40 | 0.12–0.25 |
read-common |
0.04 | 0.12 | 0.15 | 0.22 |
| 凍結書き込み・自由読み手(8 モデル) | –0.07 | 0.03–0.10 | 0.05–0.14 | –0.09 |
all-common-axis(構造的) |
0.76 | 0.72 | 0.73 | 0.74 |
表 7. エッジの重み空間 PK とその KL 効果の Spearman 相関: 全エッジ(プール)と、読み手と入力を共有するエッジグループ内の中央値。範囲は各行のモデルにわたる。
B.2 座標単位の集中は測る場所に依存する
このプロジェクトの元の動機となった観察は、凍結座標書き込みに関するものであり、そこではタスク効果が少数の残差座標に集中する。SVA では、最良層の上位 10 座標が write-common-axis 変種で正の効果の 45–83% を担い、learned モデルでは 10–13% である。極端な対の間で 3.4–8.4 倍の差になる。3 タスク全体では 32–83% と 10–21% である。各タスク内で 2 つの範囲は 11 モデルにわたって重ならず、選ばれた座標は大きさを揃えたランダム集合をすべての比較で上回る。同数の方向をヘッドの中、 の前で測ると、差は 1.4 倍(52% 対 36%、下記)に縮み、各ヘッド内のランダム回転の後では高々 1.7 倍になる。上位 10 の内部方向はコーパス S の read-common(学習書き込み)で 52%、all-common-axis で 52%、learned で 36% を担う。大きな座標単位の差はしたがって、効果を測る表現と方向に強く依存する。この縮小を基底だけに帰属させることはしない。学習された は直交ではないので、測定を の前に移すことはパッチする方向とスケールも変え、 の前後で比較されるモデルも同じ集合ではない。基底依存性のよりクリーンな検定は、モデル・層・例・介入部位を固定し、各ヘッド内の直交回転だけを変える。これはシェアを 1–8 ポイント動かす(60%、46%、35% へ)。凍結された書き込みは各内部成分が既知の座標に着地することを保証し、これが書き込みを追跡可能にする。 の前の残りの差(52% 対 36%)は異なる層とモデルにわたる単一の比較であり、解釈しない。
B.3 ヘッドの制約は効果の direct 経路を縮める
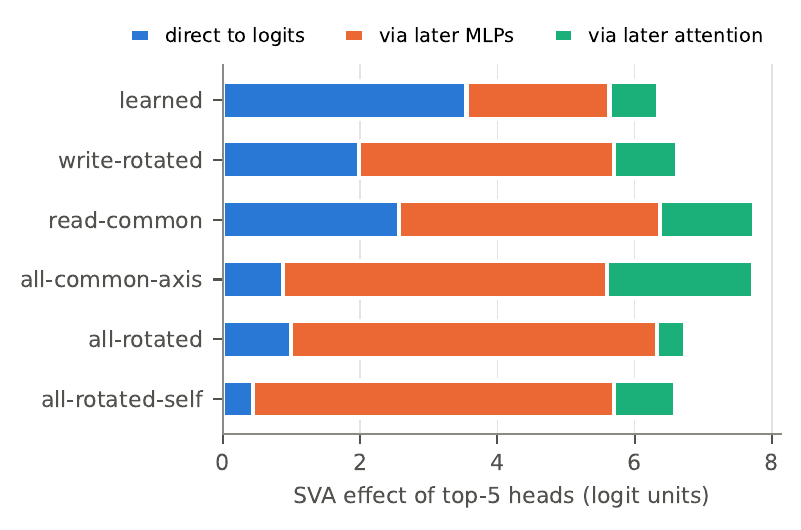
図 8. 各モデルの上位 5 ヘッドの SVA 効果の逐次クランプによる分割(コーパス S): direct = 後続の全ヘッドと源層以降の全 MLP を clean にクランプしたときの低下、via MLPs = (後続ヘッドをクランプ) direct、via later attention = total (後続ヘッドをクランプ)。分割はクランプを解除する順序に依存する(本文参照)。
上位ヘッドの効果がどの経路で出力に届くかを見るため、各上位ヘッドの SVA 効果を逐次クランプで分割した(図 8)。 を、ヘッドをパッチし、指名した部品を追加で clean 値に保ったときのロジット差の低下とする。
両方のクランプを適用した状態から、この帰属は MLP クランプを先に、ヘッドクランプを後に解除する。attention 経路と MLP 経路の相互作用はこの順序で割り当てられるので、2 つの部分は独立な経路寄与ではない。先にヘッドクランプを解除すると
となり、 が相互作用、2 つの帰属が異なる量である。
図 8 に示す MLP 先行解除の帰属では、direct 経路は learned の 3.55 ロジット単位から all-common-axis の 0.88、all-rotated-self の 0.44 に落ち、後続 MLP に帰属される部分は 2.08 から 4.7–5.3 に上がる。合計は同程度である。最も条件の揃った対は read-common(学習書き込み、direct 2.57)と all-common-axis(凍結書き込み、direct 0.88)である。どちらも読み手を同一に制限し、合計はほぼ等しい(7.74 対 7.72)。direct 経路の縮小は順序に依存しない。すべてをクランプして測るからである。all-rotated に ACDC が見つけた回路(閾値 0.001)では、attention への 22 エッジのうち他のヘッドから来るものは 1 つもない。20 は MLP から、2 は埋め込みから来る。
再実行できた 5 モデル(コーパス R と S の learned、R の write-common-axis)について、3 タスクすべてで両方の帰属を計算した。上位 5 ヘッド、75 のヘッド−タスクである。両クランプ条件は以前の direct 値を小数第 4 位まで再現する。以下のシェアは、部分のケースにわたる和を効果の総和で割ったものである。総計では相互作用は小さい。その大きさの中央値はヘッドの効果の 5% で、合計効果の 9%(符号付き)または 11%(絶対値)に相当する。すべてのヘッドで小さいわけではない。75 中 20 のケースで効果の 20% を、2 つで 50% を超え、最大は 90% である。コーパス R の中では、MLP シェアは learned で MLP クランプ先行解除(図 8 と同じ)が 0.42、ヘッドクランプ先行解除が 0.49 であり、write-common-axis では 0.69 と 0.81 である。direct シェアは 0.48 対 0.17。コーパス S の learned は 0.36 と 0.41、direct シェア 0.57 である。グループ間の差はこうして両方の帰属で保たれるが、個々のヘッドは順序に強く依存しうる。図 8 の制約モデルは再実行できなかったので、その分割は一方の順序でのみ得られている。それらについて順序に依存しない知見は、すべてをクランプして測った direct 効果がより小さいことである。
付録 C. 測定プロトコル
分割。 各タスクは互いに素な discovery (300)、validation (240)、evaluation (240)、holdout (32) の分割を持つ。、、leakage、経路分解、経路クランプは evaluation 分割を使い、その上位ヘッドは evaluation 分割のパッチ効果で順位づける。レーンのヒートマップと (図 5)は discovery 分割の効果を使い、上位 3 ヘッドは discovery で選んで evaluation 効果が正であることを確認する(15 すべてが正)。座標単位の集中の座標は validation で選ぶ。
座標単位の集中。 タスクの最良ヘッドの層で、1 つの残差座標( の後、残差加算の前)または 1 つの内部ヘッド方向( の前)に、最終入力位置で 1 つずつ介入する。効果はロジット差の低下である。上位 10 の低下の和を正の低下すべての和で割って報告する。これは単一方向の効果のシェアであり、10 方向への同時介入の効果ではない。回転対照では、各ヘッドの内部基底を 1 つのランダム直交行列で回転する。
クランプ。 部品を「クランプする」とは、源ヘッドにパッチを当てたまま、その部品の出力を clean 実行の値に保つことである。図 8 の経路分解は後続層の全ヘッドおよび/または源層以降の全 MLP をクランプする。図 6 の経路テストは、後の重要ヘッド 1 つ、同じインデックスを持つ後続の全ヘッド、または後続の全 MLP をクランプする。 を報告する。これは介入下での減少であって流れではなく、負にもなりうる。
PK とエッジの重要性。 15 モデル(両コーパスの learned、read-common、all-common-axis、all-rotated、all-rotated-self、コーパス S の write-rotated、write-routed A、identity 書き込みモデル plain-identity42 と 43、fixeddiag42、value384、mlp3456、identity-original42)のそれぞれで、層 の書き込みヘッドから後の層の読み手ヘッドの Q・K・V 入力へのすべてのヘッド間エッジを 1 つずつ参照プロンプトでの値に置き換え、16 の SVA validation 例で clean モデルからの出力の全語彙 KL ダイバージェンスを測った(12 ヘッドモデルで 28,512 エッジ)。PK は書き込みの 列と読み手の入力行の間の重み空間で計算する。全エッジでの Spearman 相関(プール)と、読み手と入力(Q、K、V)を共有するエッジグループ内の中央値を報告する。スクリプト: research/pk_edge_summary_2026_09_25.py。
タスク勾配の整列。 コーパス R の write-common と write-rotated について、訓練ステップ 1,024 から 65,536 で、SVA ロジット差(240 evaluation 例)の各層の attention 出力に関する勾配 を取り、例と位置で平坦化し、層間の cosine を報告する。これはタスク感受性であって訓練勾配ではない。同一インデックスの整列は、2 つのヘッドの書き込み空間への残差空間射影 と の cosine を層対とヘッドで平均したものである。本文は隣接層 cosine と同じく 4 つの訓練ステップにわたる範囲を報告する。層間で共有される書き込み空間ではこれは内部座標 の cosine に等しい。層ごとに異なる部分空間ではその角度の分も減る。勾配のレーンシェアは (一様 )である。スクリプト: research/lane_shared_gradient_2026_09_28.py。
の頑健性。 evaluation 分割の例ごとの結果(240 例、条件あたり 60)から、 を例 での低下として、(i) の代わりに による 、(ii) 例の 2,000 ブートストラップ再抽出にわたる 95% パーセンタイル区間、(iii) 4 条件それぞれの中での 、(iv) 12 ヘッドモデルについて、 によるヘッドインデックス上の と、各層内でヘッドインデックスを独立に置換した帰無分布(5,000 回)および下側 を計算した。ヘッドごとの平均は に使った要約を再現する(最大差 未満)。コードと出力: research/neff_robustness_2026_10_09.py と .json。インデックス/層の分解、差のペアブートストラップ(全モデルが共有する 240 例の 2,000 再抽出)、語彙の leave-one-group-out 分析は research/neff_paired_lexical_2026_10_09.py にある。語彙グループは主語名詞対(SVA)、最初の変数名(quote)、名詞(plural)である。
自己整列の統計量。 scaled-idempotence 統計量は Feng and Li (2026) に従う。各ヘッドについて 、ここで はヘッドの 書き込みブロック(ゲイン なし)、 はその の ブロックの転置であり、 である。 はスケール不変で、LayerNorm は無視する。最終チェックポイントの全 144 ヘッドの中央値を 5 モデル(両コーパスの learned、write-common、write-rotated、write-common-axis シード 42)で報告する。勾配比較では、 は同じ層のヘッド の 書き込みブロックを表す。言語モデリング検証セットの 512 トークン 32 系列で、ヘッドの の ブロックに関する言語モデリング損失勾配 を計算し、各ヘッドについて を 11 の の と比較した。自分の項が最大であるヘッドの割合を報告する(チャンス )。チェックポイントは write-common と write-rotated(シード 42)のステップ 0(シードから再生成した訓練初期化)とステップ 256 である。コード: research/scaled_idempotence_2026_09_28.py と research/lane_formation_timeline_2026_09_28.py。
自ブロック value 写像のスカラー部分。 identity 型書き込みと自由読み手を持つ 5 モデル(write-common-axis シード 42 と 43、その制限対角変種 fixeddiag42、容量補償の value384 と mlp3456)で、層 1–4 の を編集し、各ヘッドの自レーン写像 (そのレーンが実際に使う座標上の の ブロック)からスカラー部分 ()を取り除いた。ここで 、ただし fixeddiag42 は 。対照は代わりに等ノルムの ( はランダムな 直交行列)を取り除く。編集なしのモデルに対する各タスクの evaluation 分割でのロジット差の低下を、5 モデル 3 タスク 比較で報告する。対照の方が大きく低下したのは 2 つ(write-common-axis シード 43 と fixeddiag42、どちらも plural)である。データ: experiments/pk/results/lane-ablate-01.json。
凍結基底と出力スケール。 回転基底は直交 行列の 1 つの族から来る。、、 として、メンバー は である。ここで は Sylvester の Hadamard 行列、 は 上の Kerdock 集合の第 二次形式、 は固定された名前付きストリームからの Haar ランダム直交行列である。Kerdock 形式のすべての対和が bent であることから、異なるメンバーのヘッドブロックは の 以内の を持ち(測定値 5.332–5.336)、1 つのメンバーのヘッドブロックは直交する。構築では、PK が から 1% 超逸脱するメンバー集合を棄却する。層 はメンバー に書く()。write-common は全層でメンバー 0 を使う。all-rotated はメンバー 12–23 を読む(層 はメンバー を読む)。all-rotated-self は自分の書き込みメンバーを読む。メンバーはインデックス順に取った。24 メンバーの全ヘッドブロック間の主角を、訓練ソース(ハッシュは訓練記録と一致)で再生成して測定した。PK は 5.3320–5.3359 にある。メンバー対 の各々で、144 のヘッド対のうち 64 がちょうど 3 次元を共有し(主角ゼロ)、残りの cosine は高々 0.83 である。 と でも 16 のヘッド対が 3 次元を共有する。他のメンバー対は方向を共有しない。したがって write-rotated と all-rotated-self では層 と の書き込みブロックがこれらの次元を共有し、読み手が自層の書き込みメンバーを使う all-rotated-self では、層 のいくつかの書き込みが層 の読み手と 3 次元を共有する。all-rotated では、共有方向は書き込み同士、読み手同士、または同じ層の書き込みと読み手(その層が書く前に読む)の間に生じ、書き込みと後の読み手の間には生じない。コード: research/rotated_principal_angles_2026_10_09.py。すべての凍結書き込み(axis と rotated)には 、学習写像の初期出力スケールを掛ける。fixeddiag42 は 、identity-original42 は 1 を使う。
Leakage。 各源ヘッドについて、clean と参照の 前出力から全位置で を計算し、パッチされた attention 出力が clean とちょうど だけ異なることを検証し(フル実行での最大誤差 )、後続の全ヘッドの folded 読み取り空間に射影する。discovery 分割での選択チェックと 5.1 節の cosine・ノルム比は、保存された配列から research/leakage_checks_2026_10_07.py で再計算し、選ばれたヘッドも列挙する。direct 応答は読み手の LayerNorm と入力射影を で再評価する。total 応答はパッチされた順伝播の残差を使う。
attention の変化。 各タスクの上位 3 ヘッド とすべての後続ヘッド について、query と key から最終位置での の attention 分布を計算し、clean 分布からの全変動を例で平均して報告する。「query only」は clean な key のまま で query を再計算する。「keys only」はその逆。「direct」は両方に を使う。「total」はパッチされた順伝播の残差を使う。上位ヘッドは evaluation 分割の効果で順位づける。
2 順序の経路分解。 各タスクの上位 5 ヘッドについて 、、、 を測る。MLP は源層以降をクランプする。両クランプ状態から MLP クランプを先に解除する(図 8 の帰属)と、 が MLP に、 が attention に帰属される。ヘッドクランプを先に解除すると、 が attention に、 が MLP に帰属される。相互作用 は 2 つの attention 帰属の差である。シェアはヘッド−タスクのケースにわたる和を の和で割ったものである。分析コードはこれらの順序を、ここで使う解除順の逆、どのクランプを先に適用するかで名付けている。すべての部品をクランプし何もパッチしないチェック実行は clean 出力を正確に再現する。
回路サイズ。 ACDC (Conmy et al., 2023) の回路サイズは閾値に依存し、忠実性に基づく回路比較も一般にそうである (Miller et al., 2024)。0.001 では all-rotated は 138 エッジを要し、learned は 179 である。0.003 では順序が逆転する。回路サイズの主張はしない。