概要
学習した言語モデルは、key を番地、value を中身として使うと考えられてきた。value が中身であることを示す研究はあるが、この 2 つが対応しているか、つまりある事実を指す key で呼び出される value が、本当に呼ぶべきその事実を持っているかは、ほとんど確かめられていない。これまでの確かめは、key や value を反事実の入力のものに差し替えてきた。しかし、prompt のすべての token で差し替えると、どの token の value が読まれたかは示せず、事実の token だけで差し替えても、key と value のどちらがどのように効いたかは明らかにならない。私たちは代わりに、prefill の後で、1 つの入力の中の、色を表す 2 つの token の間で cache の key か value を入れ替える。同じ入力の中での入れ替えなので、ほかの入力から中身は入らない。そのうえで、最後の prompt の token と生成する token だけに、書き換えた cache を読ませる。2 人・2 色の課題で、2 つの value を入れ替えると、6 モデル中 5 で 0.983--1.000 の試行がもう 1 人の色を答える。問う人だけを替えると、6 モデルすべてで、選んだ head の注意はその人の色を表す token へ移る。これらを合わせると、key と value が対応していること、つまり Alice を指す key で呼び出される value が、呼ぶべき Alice の色を持っていることを支持する。これらは短い合成の文脈での結果で、長い文書では一部のモデルで弱まる。
1 はじめに
transformer は attention で文脈を読む。1 つの head の位置 の出力は
である。文脈の前のほうで述べた事実について問いに答えるとき、答えを作る位置は、前の token の cache の key と value を読む。key–value の記憶 (Miller et al., 2016) から借りたよくある見方では、key は問いの query が照らし合わせる番地で、value は答えに写される中身である。この見方では、2 つは対応しているはずである。つまり、ある事実を指す key で呼び出される value は、呼ぶべきその事実を持っているはずである。value が中身であることを示す研究はある (Dinh et al., 2026; Ding et al., 2026; Lin et al., 2026) が、この対応は、直接にはほとんど確かめられていない。それらが示していないのは、問いが key で選ぶ token の value が、問われた事実を持つものかどうかである。
これまでの確かめは、key や value を、対にした反事実の入力のものに差し替えた。Dinh et al. (2026) は prompt を処理する間に prompt のすべての token で差し替え、value だけで答えが反事実の答えに変わり、key だけでは正答率が下がるだけだった。このときどの token も反事実の入力の value を持つので、答えが変わっても、value が中身を運ぶことは示せるが、どの token の value が読まれたかは示せない。事実の token だけを差し替える確かめは、次の 2 つのどちらかである。1 つは key と value をまとめて動かすもので (Wu and Shomali, 2026)、動かした key が attention を向け直しただけかもしれない。もう 1 つは別の入力から value を持ってくるが、後ろの位置を計算し直すかを書いていないもので (Bogdan and Lindsey, 2026)、差し替えが途中の位置を通って答えに届いたかもしれない。さらに、これらの確かめでは、key や value を別の入力で計算する。多くはその入力が別の事実を述べるので、答えの変化は足された中身から来たのかもしれない。同じ事実を並べ替えただけの場合 (Bogdan and Lindsey, 2026) でも、差し替えたベクトルは別の文脈で計算されたもので、cache にもともとあったものではない(§2)。
私たちは代わりに、同じ入力の 2 つの位置の間で key や value を入れ替える。文脈は 2 人の好きな色を述べ、問いは Alice の色を問う。最後の prompt の token の手前までを prefill し、色を表す 2 つの token のすべての層と KV head の cache の key、value、または両方を入れ替えてから、最後の prompt の token と生成する token だけに書き換えた cache を読ませる。最後の prompt の token を含めるのは、答えの最初の token がその出力から予測されるからである。それより前の位置は計算し直さないので、答えが変わるとしたら、読む位置が 2 つの書き換えた token から受け取るものによってだけである。また、書き換えた key や value はすべて同じ入力から来るので、cache の key と value は同じままで、組み合わせだけが変わる。そのため答えが変われば、問いが選ぶ key を通してどの value を読むかが分かる。value はそのまま移し、key は移した先の位置で RoPE を掛け直す。図 1 に手順を示す。
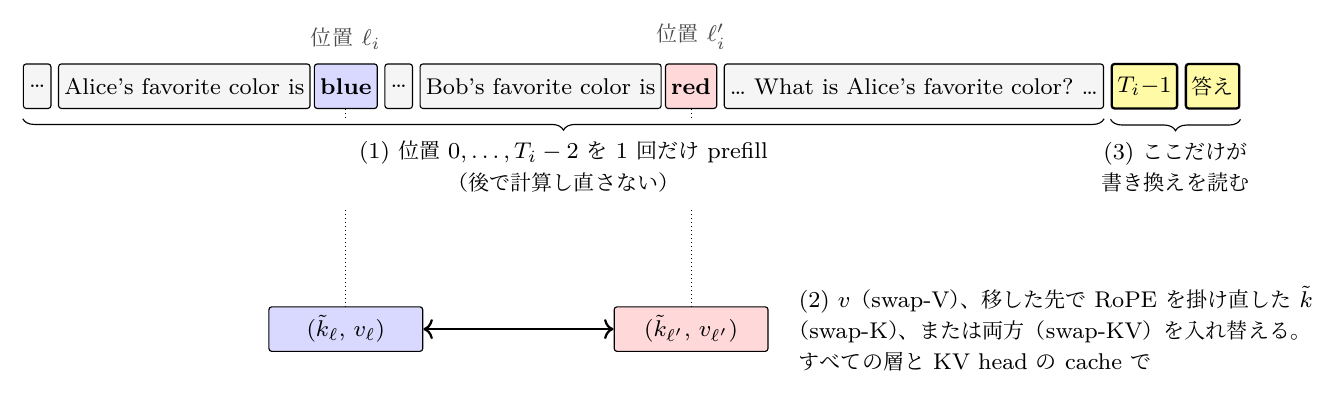
図 1. 書き換えの手順。(1) 最後の 1 つ前の token まで prompt を 1 回だけ流して cache を作る。(2) 同じ入力の中の、色を表す 2 つの token で、cache の value、key(移した先の位置で RoPE を掛け直す)、またはその両方を、すべての層と KV head で入れ替える。別の入力の中身は入らない。追加の実験では key の RoPE の位相だけも入れ替える(§3.3)。(3) 最後の prompt の token と生成する token だけを書き換えた cache で計算するので、答えが変わるとしたら、それはこれらが書き換えた 2 つの token から読んだものによってだけである。
読む位置が見るのは(key、value)の組の集合だけなので、厳密な算術ではこれらの入れ替えのいくつかは互いに等しい(§3.3)。key の入れ替えは、value の入れ替えに 2 つの key の RoPE の位相の入れ替えを重ねたものに等しく、両方の入れ替えは位相の入れ替えだけに等しい。そのため key の入れ替えは、value の入れ替えから独立な証拠を足さない。そこで追加の実験(§3.4)で、cache の組の並べ替えではない書き換え(位相だけの入れ替えと key の複製)、attention の測定、3 人の課題、もう 1 人を問う問いを足す。
学習の手順が公開された multi-head attention のモデル OLMo-2 を含む、指示調整した 6 モデルで、3 つのことが分かった。
-
色を表す token の value が答えを運ぶ。 2 つの value だけを入れ替えると、6 モデル中 5 で、決まった形の文体の 120 試行のうち 0.983–1.000、物語の文体では 0.900–1.000 の試行がもう 1 人の色を答える(§4.1)。key の RoPE の位相だけを入れ替えると、6 モデルすべて・2 つの文体で 0.983–1.000 の試行が問われた人の色のままである。これは Feng and Steinhardt (2024) が報告した位置への非依存から予想されるとおりで、発見としてではなく、等価の確かめとして使う(§4.2)。
-
問いは、自分が求めるものを持つ token に注意を向ける。 cache を変えずに、Alice ではなく Bob を問うと、選んだ head の注意は 6 モデルすべてで Alice の色を表す token から Bob の色を表す token へ移る。1 つの層の key を、その層の query を変えずに入れ替えると、6 モデルすべてで選んだ head の重みは入れ替えた key とともに動く(色を表す 2 つの token の score の差は、(試行、head)の組の 0.909–1.000 で key の中身についてくる。2 つの token の距離は 15–76 token)。1 層だけの入れ替えでは答えはほとんど変わらないので、これは答えではなく attention の測定である。value の入れ替えと合わせると、key と value が対応していること、つまり Alice を指す key で呼び出される value が、呼ぶべき Alice の色を持っていることを支持する。Alice の key を Bob の位置にも写して、色を表す 2 つの token に問われた人の key を持たせると、6 モデル中 3 で答えが Bob の色へ動く。問いが 2 つの token を区別できず、両方の中身を読みうることと合っている。残る 3 モデルはまったく動かない。この読みに従わない結果が 2 つある。Alice の色を表す token に Bob の key を持たせても、4 モデルで彼女の色が残る(0.583–0.958 の試行。0.5 以上下がるのは 1 モデル)。また、選んだ head から彼女の色を表す token への辺を止める確かめは、正の対照が 6 モデルすべてで届かず判定できなかったので、attention を測った head が、入れ替えた value が答えを変える経路そのものであることは示していない(§4.2)。
-
例外がある。 Llama-3.1-8B では、決まった形の文体で value の入れ替えが Bob の色を答えさせるのは、Alice の事実が先なら 0.774 の試行、Bob の事実が先なら 0 で、後者では答えが Alice の色を Bob のものだと述べる。別の診断は、前にある assistant の見出しの token が元の色を中継していることを、候補として示唆する(§4.4)。短い文脈から約 16k token の Wikipedia の文書へ、Qwen2.5 の 2 モデルで、key の入れ替えが value の入れ替えより大きく効き目を失う(Bob の色が 0.95 から 0.29、0.93 から 0.42。value の入れ替えは 1.00 から 0.96、0.94 から 0.75)。key の入れ替えは value の入れ替えに位相の入れ替えを重ねたもので、そこでは位相の入れ替えだけでも問われた人の色が残りにくいので、これは RoPE の位相への感度が大きくなることと合う。ただし 2 つの token の距離や文書の種類とは分けておらず、key のせいとはしない。7 モデル中 4 は長い長さで比べられない(§4.3)。
2 つ目の結果は、attention の測定と入れ替えからの推論にもとづき、何が答えを決めるかを測ったものではない。attention は別の試行で選んだ head の試行の平均で、全層を書き換えると読む層の query も変わり、Bob を問う問いは問いの意味と prompt の最後の人名とを分けない。また、問われた事実の token が答えに要るとも主張しない。Alice の値の token を見えなくしても彼女の色が残るモデルがあり、測っていないほかの位置を通る可能性がある。長い文書の確かめを除き、結果はすべて、2〜3 人・1 属性の短い合成の文脈のものである。
§2 で関連研究を、§3 で書き換えと追加の測定を定め、§4 で結果を述べ、§5 で考察し、§6 に限界を挙げる。
2 関連研究
番地と中身としての key と value。 記憶を持つネットワークは、番地を引くための key と読み出す value を分ける (Miller et al., 2016)。attention は、query を key と照らして value に重みを付けるものとして定義された (Vaswani et al., 2017)。回路の分析は、attention を、どこに注意を向けるかを決める query–key の回路と、何を運ぶかを決める output–value の回路に分ける (Elhage et al., 2021)。これらはこの分担を定義するが、学習したモデルの中で特定の位置の key や value を書き換えて確かめてはいない。回路の分析は、key と value のベクトルが低ランクの行列の途中の量で、head の計算を変えずに付け替えられるとも述べている。
別の入力の key や value への差し替え。 Dinh et al. (2026) は、長さをそろえた事実と反事実の prompt の間で、prompt を処理する間、すべての prompt の位置の key だけ・value だけ・両方を差し替える。value だけで 7 モデルが反事実の答えを出し(OLMo-2 の約 50% から Qwen2.5 の約 90% まで)、両方ではすべてで反事実の答えになり、key だけでは事実の正答率が 30–40% に下がるだけだった。Ding et al. (2026) は、GPT-2 規模の潜在の chain-of-thought のモデルで、別の問題の cache から key ではなく value を差し込むと答えが移ることを、Lin et al. (2026) は、別のモデルの value の再利用が key の再利用より安全性の振る舞いを大きくずらすことを示す。Yamakoshi et al. (2023) は masked language model で、最小対の間で query・key・value を別々に差し替える。Bogdan and Lindsey (2026) は、元の prompt から同じ位置へ key だけ・value だけを差し替える。prior-entity の条件では key の効果が value より大きく、著者はそれを attention が次の entity を探していることと読むが、図では current-entity の条件で value の効果が少なくとも同じくらい大きい(本文ではこれに触れていない)。彼らの source の prompt は同じ entity の順を入れ替えたものである。そのため、差し替えたベクトルは同じ事実を持つが、別の文脈で計算されたもので、target の cache にもともとあったベクトルではない。Wu and Shomali (2026) は key と value をまとめて移し、cache を読むように LoRA で学習した読み手で、同じ運び手がどこを読むかを決めることと値を渡すことの両方に使われると報告する。key と value をまとめて動かすので、key の指す先と value の中身が合っているかは確かめていない。答えが変わっても、それだけでは value が中身を運ぶとは言えない。答えが文脈のほかの位置にもあれば、動かした key が attention をその位置へ向け直しただけかもしれないからである。Wang et al. (2022) は、選んだ head の key・query・value の入力を、別の入力の活性で patching する。これらはどれも、key や value を同じ位置で差し替える。
activation patching と attention knockout。 activation patching は、ある実行の内部の活性を別の実行のものに置き換えて、情報がどこで使われるかを調べる。causal tracing は、同じ層・同じ token の residual、MLP の出力、attention の出力を元に戻す (Meng et al., 2022)。後の研究は、ほかの量と並べて、選んだ head の value を戻す例も示す (Zhang and Nanda, 2024)。attention knockout は、層の窓の中のすべての head で、選んだ位置から最後の位置への辺を止める (Geva et al., 2023)。私たちの key の複製は、同じ入力の別の位置から取った key だけの patching であり、head ごとの辺の遮断は knockout を選んだ head に限ったものである。この 3 本では、key をほかの量と分けて patching しておらず、同じ入力の 2 つの位置の間で key や value を写したり入れ替えたりもしていない。
位置、固定した下流の状態、書き換えた cache。 Feng and Steinhardt (2024) は、entity や属性の token の residual の活性を別の文脈のものに替え、下流の活性は計算し直さずに固定する。また、2 つの entity や 2 つの属性の RoPE (Su et al., 2021) の位置を入れ替える。後者ではモデルの答えはほとんど変わらず、著者はこれを位置への非依存と呼ぶ。彼らは文脈を(位置、活性)の組の集合とみなしており、これは私たちの等価の考え方(§3.3)の元になる見方である。彼らの位置の介入は、token の活性に掛ける回転を変えるもので、私たちの位相の入れ替えが 2 つの token の cache の key に行うことに当たるが、key だけでなく residual の活性に作用し、私たちのものは最後の位置だけが読む。Prakash et al. (2026) は、token の residual が、query–key の回路を通して読まれる address と、attention が後の token へ運ぶ payload を並べて持つことを示す。彼らは residual の活性に介入しており、key と value を分けてはいない。Li (2026) は、prompt の欄の cache を後ろの位置を計算し直さずに書き換え、判断が欄そのものではなく後ろの区切りの token に書かれた結論を読むことを示す。cache の一部を別の位置へ移すときには key を回し直し、value は変えない。key を動かすときの私たちのやり方と同じである。
私たちが足すもの。 私たちが全文を読んだ研究の中に、同じ入力の 2 つの位置の間で key や value を入れ替えるもの(Feng and Steinhardt (2024) が入れ替えるのは RoPE の位置だけ)、value の入れ替えと、それに位相の入れ替えを重ねたものを文脈の長さの間で比べるものは無かった。key を別の位置へ動かすとき、私たちは cache の再利用 (Li, 2026) と同じく RoPE を外して掛け直し、その選び方が 1 つの入力の中の入れ替えについて何を意味するかを分析する(3.3 節)。この調査は網羅的ではない。
3 方法
記号。 試行 の prompt は 個の token からなり、Alice と Bob の色を表す token の位置を と書く。モデルは 個の層 、 個の KV head 、 個の query head を持ち、 は query head が読む KV head である。cache は、すべての ・・位置 について、RoPE (Su et al., 2021) を掛けた後の key と value を持つ。・ は位置 の RoPE を掛ける・外す操作で、 は RoPE の前の key である。記号の一覧は付録 E にある。
3.1 課題
各試行は、Alice と Bob の好きな色(いつも互いに反対で、blue か red)を 8 つの中立な文に混ぜて述べ(2 つの事実の順は試行ごとに確率 1/2 で逆にする)、"What is Alice's favorite color? Answer with one word." と問う。決まった形の文体では、事実は "Name's favorite color is color." と書く。自然な文体では、ひと続きの話の中で、事実を 4 つの言い回しのどれかで書く。prompt は、決まった形の文体で約 115–150 token、自然な文体で約 145–180 token(3 モデルで確かめた)。モデルは greedy で答え(最大 6 token)、答えが Alice の色・Bob の色を含むかを記録する(、:包含率。§3.4 の追加の実験は、より厳しい分類を使う)。各条件 試行。試行の例は付録 D にある。
3.2 最後の位置だけが読む書き換え
prompt の位置 を普通に通して cache を作り、書き換えてから、位置 (既定は prompt の最後の位置)を通して生成する。 より前の位置は計算し直さないので、書き換えを読むのは とそれより後ろの位置だけである。すべての層 と KV head (既定はすべて)について、
参考として、書き換えなしと 2 つの対照も示す。1 つ目の対照は、2 人の色を互いに入れ替えた双子の prompt の value で、Alice の value を置き換える(patch-V)。置き換えた後は、2 つの枠が同じ色を持つ。2 つ目の対照は、Alice の値の token を位置 から先で見えなくする(mask-A)。
1 つの入力の中の入れ替えで言えること。 入れ替えは cache の並べ替えである。swap-V の後も、cache が持つ key の集合と value の集合は前と同じで、どの key がどの value と組になるかだけが変わる。そのため答えの変化は、情報を足したり除いたりしたことではなく、組み合わせによる。別の入力からの移植では、この 2 つを分けられない。key も動かすと、答えの変化を、key が attention を向け直したことと区別できない(§2)。swap-V はどの key もそのまま残す。そのため、書き換えた層では attention の重みは変わらず、書き換えが読む位置に最初に届く道は、読む value を通るものだけである。相手の色は同じ文脈にあるので、答えがちょうどその色に移れば、誰の value が読まれたかが分かる。3 人の課題では、5 モデルで、答えは入れ替えの相手の色に移り、3 人目の色には移らない(§4.2)。入れ替えは並べ替えなので、RoPE の位相と中身を分ける厳密な等価も成り立つ(§3.3)。また、長さをそろえた反事実の入力が要らないので、同じ書き換えを長い文書にも当てられる。色が 2 つだけだと、Alice の value の寄与が弱まっただけでも、残る候補として Bob の色が出うる。3 人の課題はこの点に答える。モデルが計算したとおりのまま動かすのは value だけで、動かした key は新しい位置に合わせて回し直す。
3.3 入れ替えで示せることと示せないこと
1 つの層・1 つの KV head で、Alice と Bob の値の token の、RoPE を掛ける前の key を 、value を と書く。1 つの位置に cache された(key、value)の組を枠(slot)と呼ぶ。文脈を(位置、活性)の組の集合とみなす見方 (Feng and Steinhardt, 2024) に従うと、位置 のどの query の出力も、それが見る(key、value)の組の集合だけで決まり、どの枠にどの組があるかにはよらない。key の中身はそのままにして、RoPE の位相だけを相手の位置のものにする操作を、位相の入れ替えとして定める:
組の集合を比べると、厳密な算術で、 のすべての query について次が成り立つ(そのような query からは 2 つの位置がどちらも見え、モデルは RoPE のほかに位置で変わる項を足さず、dropout も無い):
図 2 に、各書き換えでの組を示す。したがって、両方の入れ替えで 0.983–1.000 の試行が Alice の色を答えたこと(§4.1)は、2 つの key の RoPE の位相だけを入れ替えても、答える色がほとんど変わらなかった、ということである。key の入れ替えは、value の入れ替えに位相の入れ替えを重ねたものである。そのため、key の入れ替えと value の入れ替えは独立な 2 つの証拠ではない。両者が一致したことが示すのは、value の入れ替えが答えを移し、そこに位相の入れ替えを重ねてもここでは元に戻らない、ということである(重ねたものが、どちらか単独と違う振る舞いをすることは、原理的にはありうる)。key に固有の証拠には、組の並べ替えではない操作(value はそのままに、一方の key の中身を他方の位置に写すなど)と、書き換えの後の attention の測定が要る(§3.4、結果は §4.2)。
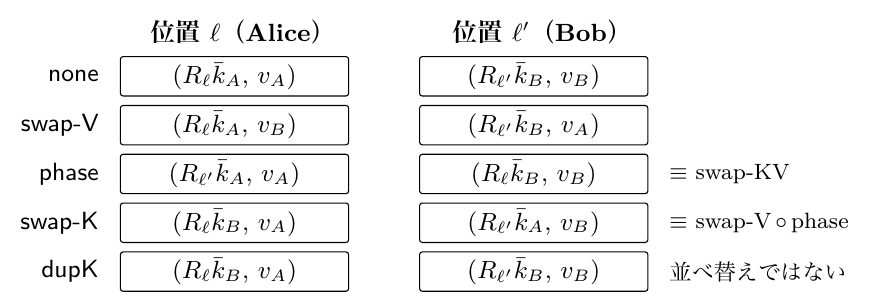
図 2. 1 つの層・1 つの KV head での、2 つの色の位置の cache の(key、value)の組。 は RoPE を掛ける前の key、 は位置 の回転。読む位置が見るのは組の集合だけなので、両方の入れ替えは位相の入れ替えと等しく、key の入れ替えは value の入れ替えの後に位相の入れ替えを重ねたものと等しい。Bob の key の中身を Alice の位置に写す操作(dupK、図は )は並べ替えとして書けないので、key を直接試す(§4.2)。
3.4 key に固有の追加の測定
追加の実験では、cache の組の並べ替えではない操作、attention の測定、3 人の課題、Bob を問う問いを足す。試行は同じ決まった形の 120 試行(答えの水準の条件は自然な文体も)、モデルは同じ 6 つ、書き換えは からだけ読ませる。下の閾値はどれも実行の前に決めた値で、私たちが選んだものであり、標準の基準ではない。
答えの分類。 答え(6 token。切れていれば 16 token に延ばす)を小文字にして前後を削り、色だけ、または前に "Alice's favorite color is"、"her favorite color is"、"the answer is"、"answer:" のどれかが付いた色だけのときに限り、Alice の色(A)か Bob の色(B)に分類する。それ以外は とする。条件 での分類を として、
この分類は (部分文字列で数える)より厳しい。判定に使う条件のどれかで なら、その判定は判定不能とする。
入れ替えに足した書き換え。 、 として、すべての層と KV head で:
§3.3 の位相の入れ替えも流す。これらの書き換えでは value は変えない。dupK は、2 つの枠に同じ key の中身と違う value を置くので、組のどんな並べ替えでも作れない。
attention の score と重み。 層 、KV head を読む query head について、(mask の前に float32 で記録)とし、位置 から 、 への重みを とする。head は、書き換えなしで、評価の試行と重ならない別の 120 試行で選ぶ:
(モデルごとに 35–53 個の head)。1 つの層だけの key の入れ替え では層 だけを書き換えるので、位置 の層 の query は書き換えなしと同じで、そこの score の変化は key だけによる。
とし、 と定める。 は同じ key の中身をもう一方の位置へ動かしたときの score の変化、つまり RoPE の位相だけによる変化である(厳密な算術で。上付きの は省いた)。、 として
とする。 は、位相だけでは元の score の差の半分以下しか説明できない、つまり差が key の中身に従う要素の割合である。あわせて、重みの変化 を示す(120 試行と選んだ head のすべてで平均し、 には絞らない)。すべての層を書き換えた後で同じ測定を繰り返すと、層 の query 自身がどれだけ変わるかが分かる。位置 の key は同じなので、 は query の変化だけによる(query の変化)。
見えなくすることと、head ごとの辺の遮断。 見えなくする操作は、位置 を、 のすべての query から、すべての層と head で隠す。辺の遮断は、head の集合 についてだけ を隠す。 は、 の大きい順に取った head の集合 ( の半分に届くまで、各層の head の半分まで。10–17 個)か、層ごとに同じ数の head を無作為に選んだ 3 つの集合 である。正の対照は、書き換えなしで を止めると が 0.3 以上下がること。
3 人の課題と、Bob を問う問い。 3 人の課題は、Alice・Bob・Carol の色(すべて違う)を無作為な順で述べ、Alice の色を問う。答えは、問われた人の色(self)、入れ替えの相手の色(part)、3 人目の色(oth)に分ける。「query が、問われた人の key を選ぶ」と「問いと関係なく Alice の key が選ばれやすい」を分けるため、同じ 2 人・3 人の文脈で "What is Bob's favorite color?" とも問う。問い 、書き換えなしで
prompt の最後に出る人名はいつも問われた人なので、これらの条件は、問いの意味で選ぶことと、最後の人名を手がかりにすることを分けない。
判定。 規則を表 1 に示す。数は「6 モデル中 」で示す。Llama-3.1-8B は §4.4 の既知の例外で、ほかと並べて示すが、ここで改めて説明はしない。
| 規則 | 届いたとするのは |
|---|---|
| 位相 | かつ |
| 1 層の score | かつ |
| key の複製 | dupK_AB:。dupK_BA: |
| 見えなくする | swap-K の後、 を隠すと が 0.5 以上下がり、 を隠すと 0.1 以下しか下がらない(swap-V は位置を逆に) |
| 辺の遮断 | 正の対照が届き、そのうえで を止めると が 0.3 以上下がり(bootstrap の区間が 0 未満)、各 より 0.2 以上多く下がり、もう一方の位置を止めても 0.1 以下しか変わらない |
| 3 人 | 。AliceBob の swap-V と swap-K で かつ 。BobCarol の swap-K で |
| 3 人・見えなくする | swap-K の後、相手の枠を隠すと が 0.5 以上下がり、Carol の枠を隠すと 0.1 以下しか下がらない |
| Bob・value の入れ替え | かつ |
| Bob・位相 | Bob の問いで「位相」と同じ |
| Bob・3 人 | BobAlice と BobCarol の value の入れ替えで 0.8 以上の試行が相手の色に移り、3 人目の色は 0.1 以下。位相の入れ替えで |
| Bob・attention | 、、 |
表 1. 追加の実験の判定の規則(実行の前に決めた)。辺の遮断の区間を McNemar の正確版で計算し直しても、判定は変わらない。
3.5 モデル
表 2 にモデルを示す。cache の key は RoPE を掛けた後の値を保存している。入れ替えは、1 つの KV head の cache の key と value を 2 つの位置の間で取り替えるので、grouped-query attention (Ainslie et al., 2023) のモデルでは、その KV head を読むすべての query head が入れ替えを見る。OLMo-2 では、key の射影の出力全体に RMSNorm を掛けてから RoPE を掛け、cache の key はその両方の後の値である。OLMo-2 と Olmo-3 は、ほかのモデルと違い、attention の入力ではなく出力を正規化する。Olmo-3-7B-Instruct は長い文書の実験(§4.3)にだけ使う。ソフトウェア・機械・精度は付録 A に書く。
| モデル | 識別子 | ||||
|---|---|---|---|---|---|
| Qwen2.5-3B (Qwen Team, 2024) | Qwen/Qwen2.5-3B-Instruct |
36 | 16 | 2 | 128 |
| Qwen2.5-7B (Qwen Team, 2024) | Qwen/Qwen2.5-7B-Instruct |
28 | 28 | 4 | 128 |
| Mistral-7B (Jiang et al., 2023) | mistralai/Mistral-7B-Instruct-v0.3 |
32 | 32 | 8 | 128 |
| Llama-3.1-8B (Grattafiori et al., 2024) | meta-llama/Llama-3.1-8B-Instruct |
32 | 32 | 8 | 128 |
| Phi-3.5-mini (Abdin et al., 2024) | microsoft/Phi-3.5-mini-instruct |
32 | 32 | 32 | 96 |
| OLMo-2-7B (OLMo Team, 2024) | allenai/OLMo-2-1124-7B-Instruct |
32 | 32 | 32 | 128 |
表 2. モデル(Hugging Face の識別子)。:層の数、・:query head と KV head の数、:head の次元。Olmo-3-7B-Instruct(allenai/Olmo-3-7B-Instruct、Olmo Team, 2025)は長い文書の実験にだけ使う。
4 結果
4.1 短い文脈
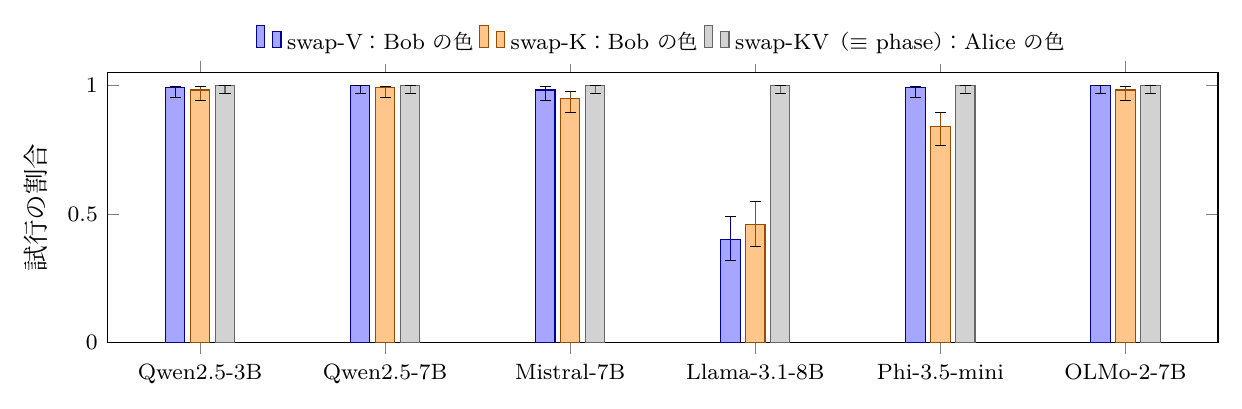
図 3. 短い文脈、決まった形、最後の prompt の token から後だけが読む書き換え、全層・全 KV head、各棒 。棒は、片方の入れ替えの後の Bob の色の包含率と、位相の入れ替えに等しい両方の入れ替え(§3.3)の後の Alice の色の包含率。誤差の棒は Wilson の 95% 区間。すべての数は表 3。
図 3 に主な結果を、表 3 にすべての条件の を示す。5 モデルで、swap-V は答えを Bob の色に移し(0.983–1.000)、swap-KV(位相の入れ替えと等しい)は Alice の色のままにし(1.000)、swap-K(value の入れ替えに位相の入れ替えを重ねたもの)は Bob の色になる(0.842–0.992)。自然な文体(付録 B の表 7)でも同じだった(片方の入れ替えで Bob が 0.875–1.000、両方で Alice が 0.983–1.000)。Alice の値の token は、どのモデルでも彼女の色に要るわけではない。それを見えなくしても(mask-A)、決まった形で Alice の色が残る試行は、Llama-3.1-8B で 1.000、OLMo-2 で 0.442、Qwen2.5-7B で 0.350 である(自然な文体で 0.992、0.492、0.342)。色がほかの位置から漏れるというのは説明の候補で、どの位置が運ぶかは測っていない(OLMo-2 の mask-A では、保存した 6 token の答え 120 件中 19 件が "Alice's favorite color is:" で終わり、どちらの色にも数えていない)。
| モデル | none | mask-A | patch-V | swap-V | swap-K | swap-KV |
|---|---|---|---|---|---|---|
| Qwen2.5-3B | 1.000/0.000 | 0.000/1.000 | 0.000/1.000 | 0.008/0.992 | 0.017/0.983 | 1.000/0.000 |
| Qwen2.5-7B | 1.000/0.000 | 0.350/0.650 | 0.000/1.000 | 0.000/1.000 | 0.008/0.992 | 1.000/0.000 |
| Mistral-7B | 1.000/0.000 | 0.000/0.008 | 0.000/1.000 | 0.000/0.983 | 0.017/0.950 | 1.000/0.000 |
| Llama-3.1-8B | 1.000/0.000 | 1.000/0.000 | 0.000/1.000 | 0.600/0.400 | 0.542/0.458 | 1.000/0.000 |
| Phi-3.5-mini | 1.000/0.000 | 0.008/0.992 | 0.000/1.000 | 0.008/0.992 | 0.158/0.842 | 1.000/0.000 |
| OLMo-2-7B | 1.000/0.000 | 0.442/0.367 | 0.000/1.000 | 0.000/1.000 | 0.017/0.983 | 1.000/0.000 |
表 3. 決まった形の文体、最後の prompt の位置から後(生成する token を含む)が読む書き換え、全層・全 KV head、。値は 。
4.2 key に固有の対照
追加の実験(§3.4)の判定を表 4 に、主な数を表 5 にまとめる。
実装の確かめ。 書き換えなし、swap-V、2 つの key の入れ替え、mask-A を流し直すと、6 モデルすべてと 2 つの文体で、前の数と 2 試行以内で一致した。厳密な算術で等しい 4 組の書き換え(§3.3)は、4 モデルで答えが完全に一致した。OLMo-2 と Llama-3.1-8B では一致は 0.975–1.000 で、読み直した試行はどれも float32 で流し直すと一致したので、違いは bf16 の丸めと合う。同じ位置で RoPE を外して掛け直しても、6 モデルすべてで 120 中 119 以上の答えが変わらなかった。
RoPE の位相。 RoPE の位相だけを入れ替えても(phase)、6 モデルすべてと 2 つの文体で答えの分類はほぼ変わらなかった( 0.983–1.000。6 中 6)。
1 層の score。 1 つの層の key だけを入れ替え、その層の query が変わらないようにすると、6 モデルすべてで、2 つの枠の score の差は位置ではなく key の中身に従った(6 中 6)。選んだ head の要素のうち のもの(全要素の 0.816–0.946)の中で、位相だけでは差の半分以下しか説明できない要素の割合は 0.935–1.000、 0.909–1.000 で、重みも key のベクトルについて動いた( は から 、 は から )。これは key のベクトルと RoPE の位相を比べただけで、key が人名のような特定の種類の情報を表すことは示さない。1 層だけの入れ替えでは答えはほとんど変わらない(40 試行で最大 0.25、Qwen2.5-3B の 1 つの層)ので、これは答えではなく attention の測定である。
すべての層を書き換えた後。 すべての層を書き換えると、読む層の query も変わる。同じ書き換えた key について、query の変化だけによる score の変化は、5 モデルで中央値が元の差の 0.108–0.225 倍(Llama-3.1-8B では 0.424–0.425 倍)、元の差の半分を超える要素は 15–28%(Llama-3.1-8B では 44–46%)だった。key を変えない swap-V の後でも、swap-K の後と同じくらいだった。key のベクトルに従う割合は 0.686–0.936、 0.381–0.792 に下がった。したがって、すべての層を書き換えたとき、query を厳密に変わらないとは扱えない。近似として十分かは判定していない(事後の記述)。
key の複製。 Alice の key の中身を Bob の枠に写すと(dupK_AB)、3 モデルで、2 つの文体とも 0.2 以上の試行が Alice の色から外れ(決まった形で OLMo-2 0.467、Phi-3.5-mini 0.333、Qwen2.5-3B 0.275。大半は Bob の色へ)、残る 3 モデルはまったく動かなかった(0.000–0.008)。Bob の key の中身を Alice の枠に写すと(dupK_BA)、Alice の色が 0.5 以上減ったのは Qwen2.5-7B だけで(1.000 からちょうど 0.500)、4 モデルでは減らず、Mistral-7B は答えがすべて で判定不能だった。自然な文体では、届いたモデルは無い(判定不能 3)。このとき 2 つの枠は問われた人の key を持つので、問いは 2 つを区別できず、モデルによって動いたり動かなかったりすることは、両方の value が読まれうることと合っている。ただしこの読みでは、動かない 3 モデルは予想されない。Qwen2.5-3B と Phi-3.5-mini で動いたのは Alice の事実が先の試行だけなので、事実の順が 2 つのどちらが勝つかを決めているのかもしれない。逆向きでは Alice の枠から Alice の key が無くなるが、4 モデルは 0.583–0.958 の試行で Alice の色を保ち、読むことが答えに要るわけではないことと合い(§4.1)、彼女の色を表す token の key を通らずに Alice の色に届く経路があることとも合う。
見えなくすることと辺の遮断。 片方の入れ替えの後、読まれる組があると予想した枠を隠すと Bob の色が 0.5 以上下がり、もう一方の枠を隠しても 0.1 以下しか下がらなかったのは 3 モデルだった(OLMo-2、Phi-3.5-mini、Qwen2.5-3B。残る 3 は で判定不能)。色が 2 つだけなので、片方の枠を隠すと見える色が 1 つになり、これだけでは key が枠を選ぶことは示せない。head ごとの辺の遮断は 6 モデルとも判定不能だった。書き換えなしで、選んだ head から Alice の色を表す token への辺を止めても、Alice の色は 0.000–0.233 しか下がらず、正の対照に届かなかった。これは、それらの head がその token の cache の value を読んでいないことは示さない。ほかの経路や、head の集合が狭すぎることがありうる。
3 人。 3 つの違う色では、Alice と Bob の value または key を入れ替えると 0.8 以上の試行が相手の色に移り、Bob と Carol を入れ替えても答えの分類は変わらなかった。これは 5 モデルで届いた(Llama-3.1-8B は判定不能)。key の入れ替えの後、相手の枠を隠すと相手の色が 0.5 以上下がり、Carol の枠を隠しても 0.1 以下しか下がらなかったのは 3 モデルだった(残る 3 は判定不能)。相手の色から外れた試行は、全試行に対して 0.267–0.550 が Alice の色に、0.358–0.658 が Carol の色に戻るので、移した Alice の key を持つ枠を隠しても、Alice の色にはまだ届く。
Bob を問う。 書き換えなしでは、6 モデルすべてが、すべての試行で両方の問いに正しく答えた。Bob の問いで、value の入れ替えにより答えが Alice の色に移ったのは 4 モデルで(Qwen2.5-3B では 0.142 の試行が Bob の色のままで届かず、Llama-3.1-8B は判定不能)、位相の入れ替えでは 6 モデルすべてで変わらなかった。3 人で Bob を問うと Bob の色を答え、Bob の value を Alice または Carol のものと入れ替えると、その相手の色に移った。これは 5 モデルで届いた(Llama-3.1-8B は判定不能)。書き換えなしで、Alice の問いで選んだ head は、Alice の問いでは Alice の値に多く重みを置き( 0.194–0.313)、Bob の問いでは Bob の値に多く重みを置いた( は から )。選んだ head はどれも向きが反転し()、これは 6 モデルすべてで届いた(6 中 6)。head は Alice の問いで選んだので、 は選び方から期待され、情報があるのは と である。問いを替えるので query も替わり、これは query を固定した測定ではない。試行で平均した重みであり、これらの head が答えを決めることの証明ではなく、問いの意味と prompt の最後の人名を分けない。
| モデル | Ph | SL | KD | Ma | EB | 3P | 3PM | BV | BP3 | BAt | |
| AB | BA | ||||||||||
| Qwen2.5-3B | × | ? | × | ||||||||
| Qwen2.5-7B | × | ? | ? | ? | |||||||
| Mistral-7B | × | ? | ? | ? | ? | ||||||
| Llama-3.1-8B | × | × | ? | ? | ? | ? | ? | ? | |||
| Phi-3.5-mini | × | ? | |||||||||
| OLMo-2-7B | × | ? | |||||||||
| 届いた数 | 6 | 6 | 3 | 1 | 3 | 0 | 5 | 3 | 4 | 5 | 6 |
表 4. 追加の実験の判定(決まった形。「位相」と「key の複製」の dupK_AB は自然な文体でも同じ)。列:Ph 位相、SL 1 層の score、KD key の複製(AB、BA)、Ma 見えなくする、EB 辺の遮断、3P 3 人、3PM 3 人・見えなくする、BV・BP3・BAt Bob の問いでの value の入れ替え・3 人・attention(Bob の問いでの位相の規則は 6 モデルすべてで届いたので表に入れていない)。:届いた、:届かない、?:判定不能。
| モデル | dupK_AB | (dupK_BA) | |||
|---|---|---|---|---|---|
| Qwen2.5-3B | 0.991/0.991 | /0.294 | 0.275 | 0.717 | 0.313/ |
| Qwen2.5-7B | 0.998/0.998 | /0.290 | 0.000 | 0.500 | 0.305/ |
| Mistral-7B | 0.994/0.998 | /0.191 | 0.008 | 0.000(すべて amb) | 0.194/ |
| Llama-3.1-8B | 1.000/1.000 | /0.189 | 0.000 | 0.958 | 0.194/ |
| Phi-3.5-mini | 0.935/0.909 | /0.285 | 0.333 | 0.783 | 0.290/ |
| OLMo-2-7B | 0.999/0.999 | /0.228 | 0.467 | 0.583 | 0.237/ |
表 5. 追加の実験の主な数(決まった形)。:1 層の score。:重みの変化。dupK_AB:Alice の色から外れた割合。(dupK_BA): に対して。:2 つの問いでの、選んだ head の重みの偏り。
4.3 長い文書
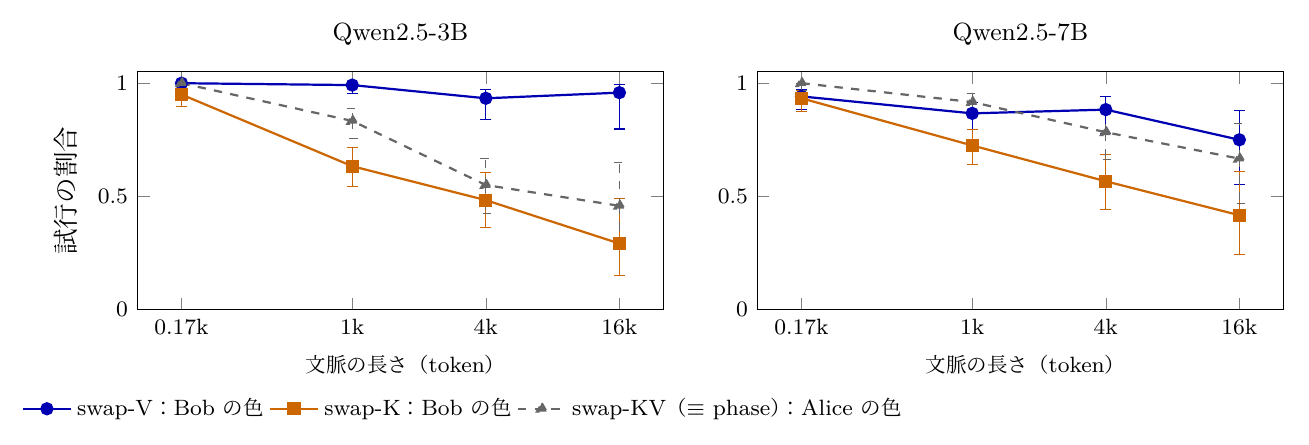
図 4. 長い文書。長さの規則を満たす 2 モデル(表 6)。いちばん左の点は自然な文体の合成の短い文脈(約 170 token)、ほかは約 1k・4k・16k token の Wikipedia の文書(、120、60、24)。包含率なので、約 1k・4k の点は下限。誤差の棒は Wilson の 95% 区間。短い文脈から 1k への下がりでは、文書の種類も変わる。
同じ 2 つの事実の文を Wikipedia の記事(122 記事)に入れ、約 1k・4k・16k token の文脈を作る(、60、24 試行)。この節の割合はどれも包含率で、答えの最初の 6 token に色の語を含むかを数えたものであり、正答かどうかではない。約 1k・4k と mask-A では、どちらの色も含まない答えが少なくないので、そこでの割合は下限である。
図 4 に Qwen2.5 の 2 モデルを示す。key の入れ替えは value の入れ替えより大きく効き目を失う。Bob の色は、自然な文体の短い文脈から約 16k token で、Qwen2.5-3B では 0.95 から 0.29 へ、Qwen2.5-7B では 0.93 から 0.42 へ下がり、Qwen2.5-3B の value の入れ替えでは 1.00 から 0.96 である。この下がりは 2 段に分けて読み、どちらも長さだけの効果とはしない。合成の短い文脈から約 1k token の Wikipedia の文書へ(文書の種類も変わる)と、同じ作りの Wikipedia の中での約 1k から 16k である。約 16k で key の入れ替えの答えが Bob の色を含まなかった試行は、測った 5 モデルすべてで、Alice の色だけを含んでいた。
表 6 は、1 つの長さの規則をすべてのモデルに当てたもの。規則を満たすのは Qwen2.5 の 2 サイズで、Llama-3.1-8B は満たさない。Llama の key の入れ替えの効き目は約 1k token で既に小さい(0.35)ので、規則は Llama についてはほとんど何も言わない。Mistral-7B、Phi-3.5-mini、Olmo-3-7B、OLMo-2-7B は、長い長さで書き換えなしの答えが既に 11.7–33% の試行で誤っているので比べられない。Mistral-7B も key の入れ替えでの割合が同じく下がるが(、)、規則で除いている。Olmo-3 では、1k から 16k で value の効き目のほうが key より大きく下がる(0.875 から 0.583、key は 0.558 から 0.375)が、16k では full attention の 8 層だけが入れ替わるので、長さの効果を、層の範囲やモデル自身の誤りと分けられない。attention の入力ではなく出力を正規化する 2 モデル(OLMo-2、Olmo-3)は、どちらもこの形の根拠を足さない。
ここでの key の入れ替えは、移した先の位置で RoPE を掛け直すので、value の入れ替えに位相の入れ替えを重ねたものと等しく(§3.3)、その割合が下がることは、key に固有の働きの低下とは区別する。位相の入れ替えだけに等しい両方の入れ替えでも、長い長さでは Alice の色が残りにくい。短い文脈から約 16k token で、Qwen2.5-3B は 1.00 から 0.46、Qwen2.5-7B は 1.00 から 0.67、Mistral-7B は 0.99 から 0.58 である。したがってこれらの文書では、答えが位相の入れ替えそのものに、短い文脈より敏感である。長さとともに 2 つの token の距離と文書の種類も変わり、これらは分けていない。Llama-3.1-8B の template の token による中継の候補(§4.4)は、長い文脈では測っていない。
| モデル | 判定 | 書き換えなしの正答の最小 | ||
|---|---|---|---|---|
| Qwen2.5-3B | 0.342 | 0.033 | key の効き目のほうが大きく下がる | 0.983 |
| Qwen2.5-7B | 0.308 | 0.117 | key の効き目のほうが大きく下がる | 0.992 |
| Llama-3.1-8B | 0.100 | 基準を満たさない | 0.958 | |
| Mistral-7B | 0.417 | 0.225 | 比べられない | 0.833 |
| Phi-3.5-mini | 0.100 | 比べられない | 0.875 | |
| Olmo-3-7B | 0.183 | 0.292 | 比べられない | 0.667 |
| OLMo-2-7B | 0.192 | 0.208 | 比べられない | 0.883 |
表 6. 長い文書:約 1k token から最も長い長さまでの、key の入れ替えと value の入れ替えの効き目(Bob の色の包含率)の下がり幅と、長さの規則の判定。書き換えは、最後の prompt の位置から後(生成する token を含む)が読む。、 も同じ。、。「key の効き目のほうが大きく下がる」 かつ 。書き換えなしの正答がどれかの長さで 0.9 を下回るモデルは「比べられない」。規則は Olmo-3 と OLMo-2 を流す前に決め、前の 5 モデルには事後に当てた。基準の 0.15 は、その 5 モデルの結果を見て置いた。全層を入れ替えた。ただし Olmo-3 の約 16k では full attention の 8 層だけを入れ替えた。最も長い長さは約 3.5k token。この実行は 2 試行で私たちの照合にも外れた(色は同じで書式だけが違う)ので、値は参考として示す。
4.4 Llama はどこで値を読むか
Llama-3.1-8B では、mask-A でもすべての答えが Alice の色のまま(1.000)で、片方の入れ替えで Bob の色を答えるのは、決まった形の文体で 0.400(swap-V)と 0.458(swap-K)にとどまる(自然な文体では 0.442 と 0.383)。この割合は 2 つの組の平均である。Alice の事実が先の 62 試行では 0.774 と 0.887、Bob の事実が先の 58 試行ではどちらも 0.000 で、58 試行のうち 46 と 47 では、答えが Alice の元の色を Bob のものだと述べる("color is actually Bob's favorite ...")。自然な文体では 0.569 と 0.615 に対して 0.291 と 0.091。書き換えは出力を変えている。入れ替えと patch-V の後の答えで、書き換えなしと同じ文字列のものは 120 中 0 で、patch-V はすべての試行で反対の色を答える。ただし色が 2 つで、双子では両方の色を替えるので、どちらの枠から色を取り出したかは分けられない。
決まった形の最初の 40 試行で、読み始める位置 を 1 token ずつ前へずらした。assistant の見出しの token <|start_header_id|> を読み手に加えたとき、Bob の色の包含率は value の入れ替えで 0.45、key の入れ替えで 0.40 上がる(この 40 試行での包含率の絶対差)。これは最後の位置を加えたとき(0.38 と 0.48)と同じくらいで、質問の token は多くても 0.10。この token が元の色を中継していることは説明の候補で、それがその token の value によるのか key によるのかは分けていない。この種の中継は、prompt の欄から計算する判断について示されている。欄の cache を書き換える前に計算された欄より後ろの位置が結論を持ち、後の token がそれを読む (Li, 2026)。Llama-3.1-8B では確かめていない。
2 つの値の token のうち後ろのものの直後から書き換えを見せると(2 つの値の間の位置は元の計算のまま)、Llama の片方の入れ替えは 0.800(swap-V)と 0.742(swap-K)で Bob の色になり、Alice の事実が先で 1.00 と 0.98、Bob の事実が先で 0.59 と 0.48、swap-KV は Alice のまま(1.000)である。この形で試したほかの 4 モデルでは、片方の入れ替えは 0.642–0.983 で Bob の色になる。追加の実験の判定を 2 つの順に分けて出し直した結果は、事後の記述で判定の数に入れず、付録 C に置く。
5 考察
value の入れ替えが示すこと。 value の入れ替えは key を 1 つも変えないので、書き換えが最後の位置に届く道は、何を受け取るかだけである(後の層で attention の重みが変わりうるのは、最後の位置自身の状態が既に変わったからにすぎない)。それが 6 モデル中 5 で答えを Bob の色に移したことは、事実の位置の value が答えに写される中身であることと整合する。すべての prompt の token の value を反事実の入力のものに替える方法 (Dinh et al., 2026) と違い、この入れ替えは色を表す 2 つの token だけに触れ、別の入力の中身を持ち込まないので、この 2 つの token の value を入れ替えるだけで答えが移ることを示す。
key の役割を示すもの。 key の入れ替えは、value の入れ替えと独立な証拠を足さない。それは value の入れ替えに RoPE の位相の入れ替えを重ねたもので(§3.3)、両方の入れ替えは、位相の入れ替えだけでは答える色がほとんど変わらないことを示す。これは、entity や属性の活性の RoPE の位置を入れ替えたときに Feng and Steinhardt (2024) が報告した位置への非依存と合う。ここでの入れ替えは、2 つの token の cache の key に限り、最後の位置だけが読む。事実の位置の key が問いの query の照らし合わせの相手であるかは、代わりに attention の水準で示す。1 つの層の query を固定すると、色を表す 2 つの token の score の差は、6 モデルすべてで、入れ替えた key の中身とともに動く。問いが Bob を問うと、選んだ head の重みは Alice の色を表す token から Bob の色を表す token へ移る。value の入れ替えと合わせて、私たちはこれを、問われた人の key と組の value に問いが求める中身が入っている、つまり key が呼ぶべきものを呼んでいる、と読む。色を表す 2 つの token に問われた人の key を持たせる key の複製は、6 モデル中 3 で答えを Bob の色へ動かし、問いが両方の value を読むことと合っているが、3 モデルはまったく動かない。この読みに従わない結果が 2 つある。Alice の色を表す token に Bob の key を持たせても(dupK_BA)、彼女の色が 0.5 以上下がるのは決まった形で 6 モデル中 1、自然な文体では 0 で、3 人の課題でも、移した彼女の key を持つ枠を隠した後に Alice の色にまだ届く。つまり色を表す token の key だけが答えへの経路ではない。また head ごとの辺の遮断は 6 モデルすべてで判定不能だったので、attention を測った head が、入れ替えた value が答えを変える経路そのものであることは示していない。そのため、この読みが答えに要るとは主張しない。Alice の値の token を見えなくしても彼女の色が残るモデルもある(§4.1)。いちばん近い説明は Prakash et al. (2026) の lookback の機構で、token が query–key の回路で読まれる address と payload を並べて持つ。私たちの書き換えは、この組を cache の key と value そのもので確かめるものである。この読みのほかの限界は §6 に挙げる。
中身を運ぶ、より前の位置。 最後の prompt の token からだけ読ませる書き換えは、それより前の位置には届かない。そうした位置が既に事実を写していれば、答えは元の中身に従いうる。Li (2026) は、prompt の欄から計算する判断についてこの形を報告している。後ろの区切りの token が結論を持ち、欄自身の cache は判断の 1% 未満しか動かさない。Llama-3.1-8B の例外(§4.4)と、いくつかのモデルで mask-A の後に色が残ることはこの形と合うが、どの位置が色を運ぶかは測っていない。
長い文書。 比べられるモデルのうち、長い文書で key の入れ替えのほうが大きく下がるという基準を満たすのは Qwen2.5 の 2 サイズで、Llama-3.1-8B は満たさない。key の入れ替えは value の入れ替えに位相の入れ替えを重ねたものと等しく、位相の入れ替えだけでも約 16k token では Alice の色が残りにくいので、この低下は RoPE の位相への感度が大きくなることと合い、短い文脈で距離が長いほど位相の寄与が大きいことと向きは同じである。2 つの token の距離や文書の種類とは分けていない。長い文書では attention を測っていない。
モデルが読むものを書き換える。 この書き換えは、特定の位置の cache を、その後ろを何も計算し直さずに変える。そのため、モデルが文脈から何を読むかに介入する方法も示唆する。query が key を通して指す位置を見つけ、その位置の value だけを書き換えればよい。これは今後の課題とする。
6 限界
-
合成の課題 1 つ:2 人、属性 1 つ(色)、値 2 つ。人数を増やした場合、ほかの属性、自然に現れる事実で同じ分担が成り立つかは確かめていない。
-
色が 2 つしかないので、value の入れ替えが Alice の value の寄与を弱めただけでも、残る候補の Bob の色が出うる。Qwen2.5-3B では、Alice の value を見えなくするだけで、決まった形の 120 試行のすべてで Bob の色を答える。3 つの違う色の 3 人の課題では、5 モデルで、入れ替えにより答えが 3 人目ではなく入れ替えの相手の色に移った(§4.2)。これはこの読み方だけでは予想されない。ただしその課題は 3 人・決まった形の文体だけである。
-
attention は、選んだ head と、prompt の最後の位置についてだけ示す。query を固定して測ったのは 1 層だけの書き換えだけである(§4.2)。すべての層を書き換えると読む層の query も変わり、書き換えなしの attention の形を仕組みの説明として読めるほど小さい変化かは判定していない。§3.3 の等価にはこれは要らない。等価な書き換えどうしでは、後ろの query も同じになるからである。
-
問う人を替える測定(Bob を問う)は、Alice の問いで選んだ head の、試行で平均した重みを示す。試行ごとの切り替わり、それらの head が答えを決めること、生成する token の間の読み方は示さず、3 人の課題では重みを記録していない。各 prompt の最後の人名はいつも問われた人なので、問いの意味と、最後の人名という手がかりを分けない。
-
読まれる token が RoPE の位相で決まっていないことは、短い文脈で、色を表す 2 つの token の距離が 15–76 token の範囲でだけ観察した。その範囲でも距離が長いほど位相の寄与は大きく、長い文書では位相の入れ替えだけで問われた人の色が残りにくくなる(Qwen2.5-3B で約 16k token のとき 1.00 から 0.46)。Feng and Steinhardt (2024) の binding ID のように、人物の番号のような情報を key の中身に入れて運ぶ仕組みは、key の中身と一緒に動くので、位相の入れ替えでは否定できない。
-
ここでの key の「中身」は、文脈に依るベクトル全体である。人名・値・周りの文の寄与は分けていない。
-
key の複製は 2 つの枠を問いから区別できなくするので、決まった答えを予言しない。6 モデル中 3 で答えが動いたことは両方の value が読まれうることと合うが、どちらの枠が読まれたかは示さず、そのうち 2 モデルでは Alice の事実が先のときだけ動く。head ごとの辺の遮断は正の対照が届かず 6 モデルとも判定不能だった。後者は、選んだ head が色を表す token の cache の value を読んでいないことは示さない。
-
長い文書の形が見えたのは 7 モデル中 2。attention の入力ではなく出力を正規化する 2 モデルを含む 4 モデルは、長い長さで書き換えなしの正答が 0.9 を下回るので比べられない。長さの規則は 5 モデルには事後に当て、基準もその結果を見て置いた。文書は Wikipedia の 122 記事だけで、約 16k の 24 試行は段落が重なる(1 つの文書の段落のうち、ほかの文書にも出る割合は平均 0.506)ので、独立な文書の標本ではない。この形は key の入れ替えで測っており、それは value の入れ替えに位相の入れ替えを重ねたものと等しいので、key だけについての証拠ではない。
-
各セル最大 120 試行(16k token では 24)、各試行で greedy の生成は 1 回、試行の集合は 1 つ(head を選ぶのは重ならない別の集合)。図 3・図 4 には Wilson の 95% 区間を示すが、仮説の検定はしていない(表 1 の McNemar の正確版での計算し直しは、判定不能だった判定の bootstrap の区間を確かめただけである)。追加の実験の判定の閾値は実行の前に決め、閾値を変えたときの感度は測っていない。答えは決まった形の規則で数え、その外の答え()は読み直していない。
7 結論
同じ文脈の 2 つの位置の間で cache の key と value を入れ替え、最後の prompt の token と生成する token だけにそれを読ませた。2 つの value を入れ替えると、6 モデル中 5 で答えがもう 1 人の色に移る。key の入れ替えは value の入れ替えに位相の入れ替えを重ねたものと等しいので、key は別に確かめた。1 つの層の query を固定すると score の差は入れ替えた key の中身に従い、もう 1 人を問うと、選んだ head の attention はその人の色を表す token へ移る(どちらも 6 モデルすべて)。これらを合わせると、key と value が対応していること、つまりある事実を指す key で呼び出される value が、呼ぶべきその事実を持っていることを支持する。根拠は短い合成の文脈での、attention の水準と入れ替えからの推論である。attention を測った head が、入れ替えた value が答えを変える経路そのものであることは示していない。また、色を表す token の key だけが答えへの経路ではなく、Llama-3.1-8B と長い文書は例外である。
References
urlstyle
Marah Abdin et al. technical report: A highly capable language model locally on your phone. arXiv:2404.14219, 2024.
Joshua Ainslie et al. : Training generalized multi-query transformer models from multi-head checkpoints. arXiv:2305.13245, 2023.
Paul C. Bogdan and Jack Lindsey. Slot machines: How LLMs keep track of multiple entities. arXiv:2604.21139, 2026.
Yi Ding, Lijun Huang, and Menglin Yang. : Testing causal cache carriers in latent chain-of-thought models. arXiv:2608.27265, 2026.
Viet Hung Dinh, Ming Ding, Youyang Qu, and Kanchana Thilakarathna. Memory retrieval in transformers: Insights from the encoding specificity principle. arXiv:2601.20282, 2026.
Nelson Elhage, Neel Nanda, Catherine Olsson, et al. A mathematical framework for transformer circuits. Transformer Circuits Thread, 2021. URL https://transformer-circuits.pub/2021/framework/index.html.
Jiahai Feng and Jacob Steinhardt. How do language models bind entities in context? In International Conference on Learning Representations (ICLR), 2024. arXiv:2310.17191.
Mor Geva, Jasmijn Bastings, Katja Filippova, and Amir Globerson. Dissecting recall of factual associations in auto-regressive language models. arXiv:2304.14767, 2023.
Aaron Grattafiori et al. The Llama 3 herd of models. arXiv:2407.21783, 2024.
Albert Q. Jiang et al. 7B. arXiv:2310.06825, 2023.
Bojie Li. Models take notes at prefill: KV cache can be editable and composable. arXiv:2606.17107, 2026.
Zhiwei Lin, Jiahao Liu, Yan Liu, and Chengpeng Wang. To cache or not to cache: Understanding and mitigating safety incompatibility in cross-model KV cache reuse. arXiv:2610.15721, 2026.
Kevin Meng, David Bau, Alex Andonian, and Yonatan Belinkov. Locating and editing factual associations in GPT. In Advances in Neural Information Processing Systems (NeurIPS), 2022. arXiv:2202.05262.
Alexander Miller, Adam Fisch, Jesse Dodge, Amir-Hossein Karimi, Antoine Bordes, and Jason Weston. Key-value memory networks for directly reading documents. In Proceedings of the 2016 Conference on Empirical Methods in Natural Language Processing (EMNLP), 2016.
OLMo Team. OLMo 2 furious. arXiv:2501.00656, 2024.
Olmo Team. 3. arXiv:2512.13961, 2025.
Nikhil Prakash, Natalie Shapira, Arnab Sen Sharma, Christoph Riedl, Yonatan Belinkov, Tamar Rott Shaham, David Bau, and Atticus Geiger. Language models use lookbacks to track beliefs. In International Conference on Learning Representations (ICLR), 2026. arXiv:2505.14685.
Qwen Team. technical report. arXiv:2412.15115, 2024.
Jianlin Su et al. : Enhanced transformer with rotary position embedding. arXiv:2104.09864, 2021.
Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N. Gomez, Łukasz Kaiser, and Illia Polosukhin. Attention is all you need. In Advances in Neural Information Processing Systems (NeurIPS), 2017.
Kevin Wang, Alexandre Variengien, Arthur Conmy, Buck Shlegeris, and Jacob Steinhardt. Interpretability in the wild: a circuit for indirect object identification in GPT-2 small. arXiv:2211.00593, 2022.
Lingfeng Wu and Behzad Shomali. Written as a record, read as an address: What a forward pass leaves in an operation's KV cache. arXiv:2609.24635, 2026.
Takateru Yamakoshi, James L. McClelland, Adele E. Goldberg, and Robert D. Hawkins. Causal interventions expose implicit situation models for commonsense language understanding. arXiv:2306.03882, 2023.
Fred Zhang and Neel Nanda. Towards best practices of activation patching in language models: Metrics and methods. arXiv:2309.16042, 2024.
付録 A. 実装の細部
書き換える key と value。 cache は、層 ・KV head ・位置 ごとに、RoPE を掛けた後の key と value を保存している。私たちはこの cache の tensor を、1 つの KV head ずつ直接書き換える。grouped-query attention のモデル(Qwen2.5、Mistral、Llama)では、書き換えた KV head を読むすべての query head が書き換えを見る。RoPE を掛ける前の key は、逆の回転を掛ける で取り戻す。OLMo-2 では、key の射影の出力全体に RMSNorm を掛けてから RoPE を掛けるので、 は正規化した後の key である。ほかのモデルでは、 は key の射影の出力である。value には位置符号が掛からないので、そのまま動かす。
RoPE の精度。 RoPE を外して掛け直すときは、モデルの cos・sin の表を使う。もとの実装はこの表を float32 のまま使ったが、モデルの通常の forward は、掛ける前にモデルの dtype(bfloat16)に丸める。違いは丸めだけである。追加の実験では、同じ決まった形の 120 試行で両方の版を比べ、結果の前に決めた規則で扱いを決めた:2 つの key の入れ替えで 120 中 118 以上の答えが一致すれば、前の数のままとする。5 モデルでは一致した(一致 0.992–1.000)。Llama-3.1-8B では片方の key の入れ替えの一致が 120 中 117(0.975)だったので、規則によりそのモデルは 2 つの文体とも直した版に置き換えた(表 7。決まった形では値は同じ)。片方の key の入れ替えの両方の版(。両方の入れ替えは、どのモデルでも 2 つの版で同じ):
| モデル | 決まった形 | 自然な文体 | ||
| モデルの dtype | float32 | モデルの dtype | float32 | |
| Qwen2.5-3B | 0.008/0.992 | 0.008/0.992 | 0.058/0.942 | 0.050/0.950 |
| Qwen2.5-7B | 0.008/0.992 | 0.008/0.992 | 0.017/0.933 | 0.017/0.933 |
| Mistral-7B | 0.017/0.950 | 0.017/0.950 | 0.067/0.875 | 0.067/0.875 |
| Llama-3.1-8B | 0.542/0.458 | 0.542/0.458 | 0.617/0.383 | 0.625/0.375 |
| Phi-3.5-mini | 0.167/0.833 | 0.158/0.842 | 0.125/0.875 | 0.117/0.883 |
| OLMo-2-7B | 0.017/0.983 | 0.017/0.983 | 0.058/0.942 | 0.058/0.942 |
最後の位置だけが読む。 位置 を 1 回通して cache を作り、cache の写しを書き換えてから、位置 を通して生成する。書き換えの後に より前の位置を計算し直さないので、 より前の位置は影響を受けず、書き換えた cache を読むのは と生成する位置だけである。
ソフトウェアと機械。 どのモデルも bfloat16 で、Hugging Face の transformers(5.16.1 と 5.17.0)で動かし、生成は greedy である。答えはライブラリの scaled-dot-product attention で生成する。追加の実験の attention の score と重みは、ライブラリの eager の attention と同じ演算をする関数で記録し、各モデルの最初の 2 試行で、その重みと出力を eager の実装と照らした。Qwen2.5-3B の短い文脈の実行は Apple silicon の Mac(MPS)で、ほかの実行(追加の実験と長い文書の実験はすべて)は、1 モデルに 1 つの NVIDIA GB10 GPU(DGX Spark)で行った。追加の実験では Qwen2.5-3B を GB10 で流し直し、Mac での数を 2 試行以内で再現した。2 つの装置のあいだのほかの違いは測っていない。
付録 B. 自然な文体
表 7 に、ひと続きの話の中で事実を 4 つの言い回しのどれかで書く自然な文体での、短い文脈の結果を示す。
| モデル | none | mask-A | patch-V | swap-V | swap-K | swap-KV |
|---|---|---|---|---|---|---|
| Qwen2.5-3B | 1.000/0.000 | 0.267/0.633 | 0.000/1.000 | 0.000/1.000 | 0.050/0.950 | 1.000/0.000 |
| Qwen2.5-7B | 1.000/0.000 | 0.342/0.358 | 0.017/0.967 | 0.008/0.942 | 0.017/0.933 | 1.000/0.000 |
| Mistral-7B | 0.992/0.000 | 0.183/0.042 | 0.117/0.858 | 0.058/0.900 | 0.067/0.875 | 0.992/0.000 |
| Llama-3.1-8B | 1.000/0.000 | 0.992/0.008 | 0.108/0.892 | 0.558/0.442 | 0.617/0.383 | 1.000/0.000 |
| Phi-3.5-mini | 1.000/0.000 | 0.233/0.617 | 0.000/1.000 | 0.000/1.000 | 0.117/0.883 | 0.983/0.017 |
| OLMo-2-7B | 1.000/0.000 | 0.492/0.475 | 0.000/1.000 | 0.017/0.983 | 0.058/0.942 | 1.000/0.000 |
表 7. 自然な文体(ひと続きの話の中で、事実を 4 つの言い回しのどれかで書く)、最後の prompt の位置から後(生成する token を含む)が読む書き換え、全層・全 KV head、。値は 。RoPE の cos・sin をモデルの精度で掛けた版。付録 A の規則により、前の float32 の版(0.625/0.375)と置き換えた。
付録 C. Llama-3.1-8B を事実の順で分けた判定
Llama-3.1-8B の片方の入れ替えへの答えは、事実の順でほぼ完全に分かれる(§4.4)。そこで、決まった形の保存した記録を、Alice の事実が先の 62 試行と Bob の事実が先の 58 試行に分け、追加の実験(§3.4)の集計をそのまま流し直した。新しい生成はしておらず、head の集合は全試行で選んだものを使う。部分集合は、この分かれ方を見た後に選んだので、表 8 は事後の記述である。表 4 の「6 モデル中いくつ」の判定には数えず、看板にも使わない。
| 全試行() | Alice が先() | Bob が先() | |
|---|---|---|---|
、swap-V |
0.192/0.400/0.408 | 0.210/0.774/0.016 | 0.172/0.000/0.828 |
、swap-K |
0.125/0.458/0.417 | 0.097/0.887/0.016 | 0.155/0.000/0.845 |
| 位相 | |||
| 掛け直す key の入れ替えと掛け直さない入れ替え、 | ?、0.058 | 、0.113 | ?、0.000 |
key の複製、dupK_AB/dupK_BA |
/ | / | / |
| 1 層の score、 | 、1.000/1.000 | 、1.000/1.000 | 、1.000/1.000 |
| query の変化の中央値(記述) | 0.425 | 0.331 | 0.586 |
swap-K の後に見えなくする |
?(0.458 0.000/1.000) | (0.887 0.000/1.000) | ?(0.000 0.000/1.000) |
swap-V の後に見えなくする |
?(0.400 0.000/1.000) | (0.774 0.000/1.000) | ?(0.000 0.000/1.000) |
| 辺の遮断 | ? | ? | ? |
表 8. Llama-3.1-8B、決まった形:追加の実験の判定を、全試行と事実の 2 つの順で出したもの(事後)。「見えなくする」の欄は、見えなくする前の 読むと予想した枠を見えなくした後/もう一方の枠を見えなくした後。 は RoPE を掛け直さずに cache の key を動かす入れ替え(厳密な算術では swap-V と等しい)。 で、95% の bootstrap の区間が に入れば届いたとする。
Alice の事実が先では、見えなくする 2 条件が、本番の前に決めた閾値を満たす。これは見えなくする操作について新しい観察を足さない。見えなくした後の Bob の値の率は、全試行でも両方の順でも同じである(読むと予想した枠を見えなくして 0.000、もう一方を見えなくして 1.000)。順で変わるのは、見えなくする前の率(分けるきっかけになった量そのもの)と である。 は見えなくした後でも変わる。読む枠を見えなくした後の は、全試行で 0.150(swap-K)と 0.125(swap-V)、Alice の事実が先で 0.016 と 0.032、Bob の事実が先で 0.293 と 0.224 である。2 条件は独立な 2 つの証拠ではない。swap-K は swap-V に位相の入れ替えを重ねたものに等しく(§3.3)、62 試行のうち答えが違うのは 7 である。2 色なので、1 つの枠を見えなくすると見える色が 1 つ残り、その枠を読むことと、見えている色を答えることとは分けられない。掛け直す key の入れ替えと掛け直さない入れ替えの比べは、Alice の事実が先で届かない(、95% 区間 [0.048, 0.194] が に入らない)。これは差が の中にあると示せなかったということで、差が 0.10 を超えると示したことではない。辺の遮断は両方の順で判定不能のままなので、特定の head を通る経路は示していない。
Bob の事実が先では、swap-V と swap-K の答えの 0.828 と 0.845 が答えの分類の外にあり、多くは「Alice の色 is Bob's favorite ...」の形である。最初の 6 token の中では、すべての試行で Alice の色を含み Bob の色を含まないので、6 token の範囲では色は移っていない。分類のために 16 token に延ばした答えには両方の色を含むものがあり(swap-V で 14、swap-K で 13)、延ばした答えについてはそうは言わない。
付録 D. 試行の例
決まった形の文体の 1 番目の試行(§3 から参照。、build_set(’bind_color_rel’, 120, seed=0))の user の文を下に示す。書き換える 2 つの token に下線を引いた。この文の周りに、モデルの chat の template を当てる。OLMo-2 では prompt は token で、Alice と Bob の色を表す token は位置 と にある。
Read the following notes.
The hiking trail is closed after heavy storms. A local band will perform in the park this weekend. The bridge on the main road is being repaired. The meeting was moved to the second floor conference room. Alice's favorite color is [blue]{.underline}. A long queue formed outside the ticket office. A new bakery started selling bread near the station last month. The museum added a small exhibit about old clocks. Bob's favorite color is [red]{.underline}. The library opens at nine in the morning on weekdays.
Question: What is Alice's favorite color? Answer with one word.
この試行の OLMo-2 の保存された答え(最後の位置だけが読む書き換え、全層・全 KV head):
| 条件 | 答え |
|---|---|
| none | blue |
| mask-A | Alice's favorite color is blue |
| patch-V | red |
| swap-V | Red |
| swap-K | Red |
| swap-KV | blue |