概要
attention ヘッドは残差ストリームの部分空間から読み、部分空間へ書き、それらの部分空間が overlap すると相互作用すると説明されることが多い。しかし部分空間の定義はいくつもあり、overlap の意味もはっきりしない。本研究は、ヘッドの読み取り空間と書き込み空間を、重みが定める線形写像の核の直交補空間と像として定義する。この定義は内在的であり、なぜそれらがヘッドの読み書きする空間なのかを示す。次に、ほとんどすべての重みについて、ヘッド幅の合計が残差ストリームの次元に等しければ 1 層の書き込み空間は残差ストリームを直和分解し、層内でも層間でも任意の 2 つのヘッド部分空間は disjoint であることを示す。それでも一部の対は必ず非直交であり、disjoint な部分空間も射影を通して相互作用する。この非直交性を、情報伝達の自然な尺度であることが示される projection kernel で測る。学習済みモデルでは少数のヘッド対が強く非直交で、大半はほぼ直交している。このばらつきは同じ重みをヘッドにランダムに割り当てた場合よりはるかに大きく、学習がどの部分空間をどれだけ強く相互作用させるかを選んでいることを示唆する。
Introduction
decoder 型 Transformer(Vaswani et al., 2017)はトークンごとに 1 本のベクトル、残差ストリームを保持し、すべての attention ヘッドと MLP はそこから読み、そこへ加算する。ベクトルは列ベクトルとする。 個のヘッドを持つ層 で、ヘッド は 型の query・key・value の射影 を通して読み、 型の出力射影 を通して書く。ヘッド出力を とすると、層の attention 出力は
である。
ヘッドは残差ストリームの部分空間から読み、部分空間へ書くものとして広く記述されている。残差ストリームは、層が同じ部分空間あるいは overlap する部分空間に書き込み、そこから読むことで相互作用し、部分空間が disjoint なら相互作用しない通信路として記述され、ヘッドの部分空間は の右・左特異ベクトルから同定されている(Elhage et al., 2021)。ヘッドの対について合成した query-key 写像と output-value 写像の特異値分解からは、その間の低ランクな通信路が見出されている(Merullo et al., 2024)。ヘッドの部分空間を重み行列の列が張る空間として定義し、その間の projection kernel(PK)を部分空間の overlap、すなわちヘッドが共有しうる情報の量と解釈する研究もある(Yamagiwa et al., 2026)。読み取り空間と書き込み空間は他の研究でも言及されている(Wang et al., 2023; Feng and Li, 2026)。
これらの記述には、より明確にできる点が 2 つある。1 つ目は部分空間の特徴づけである。 の右特異部分空間と左特異部分空間は、代数的には条件付きで列空間による定義(Yamagiwa et al., 2026)と等しいが、合成された作用素が感度を持つ入力方向と出力方向を特徴づけるものであり、value と出力についてだけ与えられ、上位の特異ベクトルだけを残す場合は積のスペクトルにも依存する。列が張る空間は、同じ部分空間を行列の座標で表したものである。どちらでも、読まれる部分空間は名指されているが、読み取りが残差ストリームにその部分空間を通してのみ依存することは暗黙のままである。2 つ目は overlap の意味である。次元を帯域とみなし、disjoint な部分空間に書くヘッドは相互作用しないとする説明は、overlap を空間の共有として読んでいる(Elhage et al., 2021)。overlap することは、PK が大きいこと、すなわち部分空間が小さな主角をなす方向をより多く共有することとも述べられているが(Yamagiwa et al., 2026)、PK は主角の の和であり、空間を共有するかどうかにかかわらず、2 つの部分空間が直交しなければ非零になる。disjoint 性、直交性、相互作用の関係は明示されていない。
そこで本稿は、線形写像そのものから部分空間を定義し直す。線形写像はちょうどその核を捨てるので、あらゆる読み取りは、核の直交補空間への直交射影とその後の可逆な写像に分解される。層 のヘッド の query に関する読み取り空間を
と定義し、 と も同様に定義する。書き込み空間は である。核と像は写像の性質であり、特定の基底での行列の性質ではない。そして分解の形は、 に直交する成分が読み取りに影響しないことを示す。フルランクのヘッドで正規化を折り込む前には、これらは先行研究と同じ部分空間である。再定義が変えるのは特徴づけ方であり、加えて query と key の読み取り空間を与え、pre-attention 正規化を折り込めるようにする。
この定義のもとで、空間の配置を理論と学習済みモデルの両方で示す。1 つの層の中では、ヘッド幅の合計が に等しいとき、ほとんどすべての重みについて書き込み空間が残差ストリームを直和分解するので、それらは disjoint である。さらに、一般の重みでは、次元の和がそれらの入る空間の次元以下であるかぎり、層内でも層間でも任意の 2 つのヘッド部分空間は disjoint である。124M モデルと Qwen2.5-7B で調べた比較の範囲では、境界的な 1 対を除いて方向を共有する対はない。それでも一部の対は必ず非直交である。1 層の書き込み空間は残差ストリームを張るので、どの読み取り空間もそのどれか 1 つと非直交であり、逆にどの書き込み空間も、読み取り空間が残差ストリームを張る後の層の各種類の読み取り空間のどれか 1 つと非直交である。線形経路では、書き込みは読み取り空間への射影を通してのみ読み手に届き、この射影は 2 つの空間が直交しないときに限り、ある書き込みについて非零になる。したがって disjoint な部分空間も射影によって相互作用し、読み取り空間と書き込み空間が disjoint なら相互作用できないという記述(Elhage et al., 2021)への反例となる。本稿は overlap をこの意味、すなわち非直交性の意味でだけ使い、その度合いを PK で測る。PK は線形経路で書き込みの伝わる割合を、平均では正確に与え、1 つの書き込みについては鋭く上から抑える。
次に、124M モデル、Qwen2.5-7B、Qwen3-235B-A22B の全 94 層、Pythia-70m で各層の書き込み空間の全対について overlap の度合いを測り、124M モデルと Qwen2.5-7B では、同種の読み取り空間の全対と、書き込み空間から後の層の読み取り空間への全対も測る。どのモデルでも、強く overlap する対からなる右の裾が見つかり、なかには最小主角が 3° を下回るものもある。大半の対はランダムな部分空間と同程度に弱く overlap する。ペア間のばらつきを、学習済みのスペクトルまたは学習済みの列を保ち、どの方向がどのヘッドに属するかだけをランダム化する 2 つの帰無モデルと比較した。ある層の書き込み空間と後の層の読み取り空間の間では、ばらつきは 124M モデルの層対 読み取り種別の 198 条件のうち 197 で、Qwen2.5-7B の 1,134 条件すべてで、すべての帰無サンプルを上回る。124M モデルの書き込み空間と、両モデルの Q と K の読み取り空間でも、全層で上回る。124M モデルの実際の活性では、書き込みのうち読み取り空間に射影される割合は overlap の度合いと相関する(Spearman 0.72 - 0.77)。
本稿の貢献は次のとおりである。
-
ヘッドの読み取り空間と書き込み空間を、その線形写像の核と像によって特徴づけた。この定義は内在的であり、なぜそれらが読み取られ、書き込まれる部分空間なのかが分かる形をしている。
-
ほとんどすべての重みについて、ヘッド幅の合計が残差ストリームの次元に等しければ 1 つの層の書き込み空間が残差ストリームを直和分解すること、さらに層内でも層間でも任意の 2 つのヘッド部分空間が disjoint であることを、理論と 2 つの学習済みモデルで示した。
-
disjoint な空間でも、一部の対は必ず非直交であるために相互作用しうることを示した。線形経路では、書き込みは読み取り空間への射影を通して読み手に届き、その大きさを PK は平均では正確に与え、1 つの書き込みについては鋭く上から抑える。
-
非直交性の度合いである PK を用いて、ヘッドの対にわたる非直交性の度合いの分布に統計的な偏りを見つけた。ペア間のばらつきは、学習済み重みを保ったままヘッドへの割り当てだけをランダム化する帰無モデルを上回る。
Section 2 で関連研究を補足する。Section 3 で読み取り空間と書き込み空間を定義する。Section 4 で直和分解、射影による相互作用、必ず存在する非直交性を示す。Section 5 で学習済みモデルでの overlap の分布を測る。Section 6 で結果を議論し、Section 7 で結論を述べる。証明は Appendix A - D、補足の測定は Appendix E - H にまとめる。
Related work
ヘッド間の通信
合成スコアは前の層のヘッドが後の層のヘッドにどれだけ強く入力するかを定量化し(Elhage et al., 2021)、合成は induction head のような機構の基盤である(Olsson et al., 2022)。合成した写像のスペクトル成分は通信路を見出すために解析されている(Merullo et al., 2024)。本稿は代わりに個々の読み取り写像の空間全体を定義し、その非直交性を PK と帰無モデルで比較する。ヘッド部分空間の間の PK は間接目的語同定回路(Wang et al., 2023)のヘッド間相互作用を合成スコアより明瞭に再現し、その分布はランダムな部分空間のものと比較されている(Yamagiwa et al., 2026)。本稿はこれを学習済み重みを保つ帰無モデルとも比較し、235B パラメータまでのモデルに拡張する。
ヘッドの多様性、直交性、冗長性
ヘッドをより多様な、あるいは互いに直交する部分空間へ押す正則化があり(Li et al., 2018; Lee et al., 2019)、学習中にヘッド間の直交性が低下することが報告され(Li et al., 2021)、多くのヘッドは損失をほとんど増やさずに刈り込める(Michel et al., 2019; Voita et al., 2019)。統計理論は直交なヘッド部分空間が分散低減に最適だとする(Fokoué, 2026)。高次元では多数の方向が同時にほぼ直交でありえ、superposition はこれを利用する(Elhage et al., 2022)。
自ヘッドの幾何と正規化
数パーセントのヘッドでは実効 OV 作用素がほぼスケールされた射影である(Feng and Li, 2026)。本稿の自ヘッドの測定(Section 5.5)は符号と特異値を無視する部分空間レベルの統計量である。pre-normalization(Xiong et al., 2020)のもとでは、LayerNorm(Ba et al., 2016)や RMSNorm(Zhang and Sennrich, 2019)は残差ベクトルの方向だけを次のブロックに渡す(Riechers, 2024)。Section 4.2 はそこから生じる正規化経路を線形経路から分ける。
読み取り空間と書き込み空間
Section 1 の列規約を引き続き用いる。 について 、 であり、、 とする。上付きの は層 のヘッド を表す。 は 1 層のヘッド数、 は層 の出力行列である。
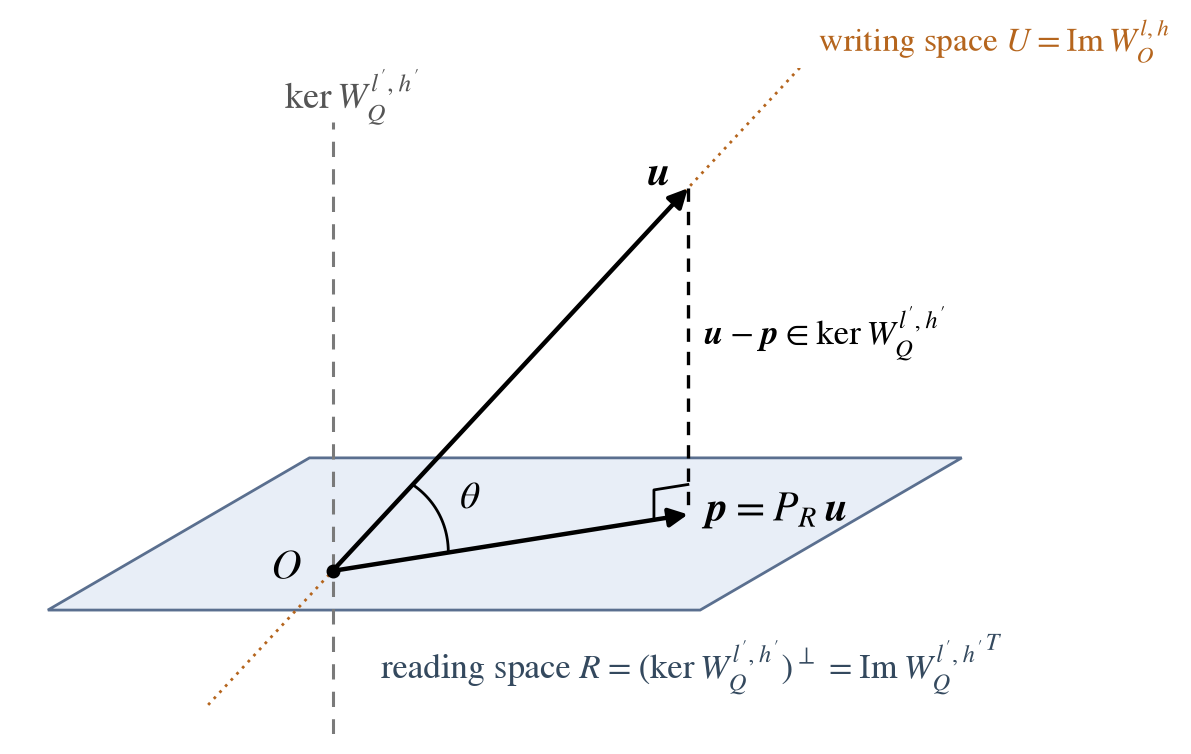
図 1. 書き込み空間と読み取り空間は disjoint だが非直交に overlap しているので、射影を通して通信する。この図は読み手の線形写像についてのものであり、後の層 のヘッド の query 写像 で示す。このヘッドは残差に、読み取り空間 (原点 を通る網掛けの平面)への直交射影を通してのみ依存する。層 のヘッド の書き込み空間 の書き込み は、 として読み手に届き、成分 は に入って読み手には見えない。 と は方向を共有しないが、 は と直交しないので は非零であり、ここでは である。実際のモデルでは両空間とも 次元だが、disjoint でありながら直交しない様子を 3 次元の中で示すため、 を 2 次元、 を 1 次元で描いている。
ヘッドの読み取りはどれも残差ベクトルの線形写像であり、書き込みはどれも線形写像の像である。部分空間をこれらの写像の核と像によって定義する。
定義 (読み取り空間と書き込み空間) 層 のヘッド と について、 に関する読み取り空間と書き込み空間を
と定める。
命題 (読み取りは読み取り空間を通って分解される) あらゆる残差ベクトル について が成り立つ。ここで は への直交射影であり、制限 は単射である。ヘッドのあらゆる書き込みは に入り、 のあらゆるベクトルは何らかのヘッド出力の書き込みである。
したがって の に直交する成分は読み取りに影響せず、射影はヘッドが使うものを何も失わない(証明は Appendix A)。 の 2 つの表示は恒等式 (Strang, 1993)によって一致する。
内在的な特徴づけ
核と像は線形写像の性質であり、特定の基底でそれを表す行列の性質ではない。重み行列の列が張る空間は同じ部分空間を座標で書いたものである。 と と書けば、これらの空間は、残差ストリームの内積のもとで基底を参照せずに定義され、ヘッド内部のどの座標変換でも変わらない。この内積は正規化と PK が用いるものでもある。フルランクのヘッドでは、これらは重み行列の列空間(Yamagiwa et al., 2026)とも、 と の特異部分空間(Elhage et al., 2021)とも一致する(Appendix A)。再定義が変えるのは特徴づけであって、先行研究が測った部分空間ではない。本稿でのその役割は、読み取り空間への射影が書き込みが読み手に届く経路になることである(Section 4.2)。
正規化
pre-attention 正規化があるとき、ヘッドは を読む。 は平均を除去する(RMSNorm では )。分子は について線形なので、定義を合成写像 に適用でき、その読み取り空間 を全体で用いる。スカラー は Section 4.2 で扱う。
直和分解、射影による相互作用、必ず存在する非直交性
直和分解の条件と、一般の対の disjoint 性
命題 (直和分解は一般的である) (a) とする。Lebesgue 測度零の集合を除くすべての について、 は 次元の 個の部分空間の直和であり、 ならこれは に等しい。写像 が定める各種類の読み取り空間についても同じことが成り立つ。(b) 次元 が を満たす の 2 つの部分空間を、密度を持つ分布から独立に引くと、確率 1 で交わりは だけである。
理由は単純である。和が直和でなくなるのは の列が線形従属になるときだけであり、 なら となるときである。そのような重みは重み全体の空間の中の曲面、つまり体積 0 の集合の上にあるので、連続分布から選んだ重みは確率 1 でそれを避け、例外的な重みもわずかに動かせばその集合から外れる。同じように、次元の和が 以下の 2 つの部分空間が方向を共有するのも体積 0 の集合の上だけであり、空間内の 2 本のランダムな直線が交わらないのと同じである。したがって 1 つの層の中の書き込み空間は disjoint であり、異なる層の一般の部分空間も、次元の和がそれらの入る空間の次元以下であるかぎり disjoint である。詳しい証明は Appendix B にある。
注意の要る場合が 3 つある。RMSNorm のゲインは可逆なので、それを折り込んでも読み取り空間の直和分解は保たれる。しかし LayerNorm の平均除去はすべての読み取り空間を平均零のベクトルがなす 次元の部分空間に写すので、 のとき、折り込んだ 1 層の読み取り空間は直和をなしえない。ただし一般の重みでは、その部分空間の中で次元条件を考えれば互いに disjoint のままである。grouped-query attention では複数の query ヘッドが 1 つの key と 1 つの value の読み取り空間を共有し、これを 1 つとして数える。その数は より少ないので、その直和は真部分空間である。Qwen3-235B の書き込み空間のように のときは、 次元ブロックの直和は存在しない。
学習が原理的に例外的な重みに到達することはありうるので、学習済みモデルで確かめる(Section 5.1)。あらゆるヘッド部分空間の対について最小主角を計算した。層内(書き込み空間どうし、および Q, K, V の読み取り空間を同種どうし)と、層 のあらゆる書き込み空間からあらゆる層 のあらゆる読み取り空間への対である。
| モデル | 比較 | ペア数 | 最小角(度) | 最小角の中央値(度) |
|---|---|---|---|---|
| 124M | 層内: O / Q / K / V | 各 792 | 8.8 / 6.1 / 3.9 / 21.3 | - |
| 124M | 層間: O と Q / K / V | 各 9,504 | 13.1 / 13.0 / 21.7 | 51 - 56 |
| Qwen2.5-7B | 層内: O / Q / K / V | 10,584 / 10,584 / 168 / 168 | 0.39 / 1.4 / 6.1 / 7.4 | - |
| Qwen2.5-7B | 層間: O と Q / K / V | 296,352 / 42,336 / 42,336 | 14.8 / 13.3 / 17.0 | 67 - 69 |
表 1. 層内と層間のヘッド部分空間の対にわたる最小主角。
最小角が 0.1° を下回る対はなく、1° を下回るのは Qwen2.5-7B 層 27 の 2 つの書き込み空間の 0.39°(sin 0.007)の 1 対だけであり、これは BF16 の丸め(相対精度約 0.4%)が生じうる摂動の数倍にすぎない。最も近い層間の対は約 13° 離れているが、それでも直交からは遠い(cos 13° = 0.97)。異なる層の書き込み空間どうしは比較しておらず、 しか取得していない Qwen3-235B では層内の書き込み空間どうしだけを比較した(Section 5.2)。
disjoint な部分空間は射影によって相互作用する
層 の書き手の書き込み空間を 、後の層 の読み手の正規化を折り込んだ読み取り写像を 、その読み取り空間を とする。ゲインを除いた正規化を 、そのヤコビアンを とすると、残差 に加えた小さな書き込み は、読み手の入力を一次の近似で だけ変える。LayerNorm では として
であり(第 1 項が線形経路、第 2 項が正規化経路)、RMSNorm でも として同じ式が成り立つ。
線形項は読み取り空間への射影を通じて決まる
であり は 上で単射なので、線形項は のとき、かつそのときに限り消える。disjoint であることは射影を消さない。線形項が のすべての について消えるのは と が直交するときだけである。平面では と は のすべてで disjoint だが、 方向の単位書き込みは のノルムで に射影され、 ならほぼすべてが届く。したがって disjoint な部分空間も射影によって相互作用し、disjoint な部分空間は相互作用しないという説明(Elhage et al., 2021)に反する。
overlap は非直交性を意味する
そこで本稿は「overlap」を 1 つの意味でだけ使う。 のとき と は disjoint であるといい、、すなわち直交しないとき overlap する という。正規直交基底行列を 、主角(Björck and Golub, 1973)を ()とすると、overlap の度合い は projection kernel(Hamm and Lee, 2008)とその正規化値
で測る。 を非直交度とも呼ぶ。 のとき、 から等方的に引いた単位書き込みでは、 への射影の二乗ノルムの期待値はちょうど であり(Appendix D)、PK は個々の書き込みの伝達も上から抑える。
命題 (PK は伝達量を抑える) のあらゆる単位書き込み について である。この上界は鋭い。 について
である。
したがって、書き込み空間から読み取り空間へ直接線形に届く成分の二乗ノルムは で上から抑えられ、この上界は鋭く、PK が 0 なら伝達はゼロになることが理論的に示される。情報伝達を、射影したベクトルのノルムという観点で評価すれば、この意味で、PK はヘッドの読み書き空間の重なりの関係を測る自然な尺度であると言える(証明は Appendix D)。したがって PK は、ヘッド間の情報伝達を測る量として用いることができる。
が大きいとき 2 つの部分空間は強く overlap する、すなわち小さな角をなすといい、小さいとき弱く overlap する、すなわち大きな角をなすという。最小主角 は別の指標である。64 次元で 1 つの主角だけが小さく残りが 90° 近くなら、 は約 1/64 にとどまる。
正規化経路
第 2 項は だけでは決まらない。 の方向を向き、 の 方向成分に比例するので、直交する空間の間でも作用しうる。一次の範囲では、 が 方向の成分を持たないときと のときに消える。前者の場合でも、 なら有限の書き込みはノルムの二次の変化を通して作用しうる。 かつ なら、有限の書き込みでも読み取りは 0 のままである。その大きさは Section 5.4 で測る。
一部の対は必ず非直交である
特定の対が直交することは測度零の条件だが、個々の対では起こりうる。しかしすべての対が同時に直交することはできない。
命題 (最大の overlap の下限) 部分空間 が を張るとし、、 を任意の 次元部分空間とする。すると
が成り立つ。ここで は の最小固有値である。
この命題より、層 の書き込み空間が を張るとき、後の任意の層 のどの読み取り空間 も、ある について と非直交である。逆に、任意の と、query の読み取り空間が を張る後の任意の層 に対して、 が と非直交となる が存在する。K, V についても同様である。前の命題より、 で読み取り空間が写像 のものなら、張るという条件はほとんどすべての重みで成り立つ。grouped-query attention の key と value の読み取り空間では成り立たない。LayerNorm を折り込むと読み取り空間は平均零の部分空間しか張らないが、 の書き込み空間はそれでもどれかの読み取り空間と非直交である。ただし定量的な下限は 0 になる。直交配置では で、下限は Section 5.1 の等方値 に等しく、一般には の分だけ弱くなる(証明は Appendix C)。
どちらの学習済みモデルでも、読み取り空間を固定した向きの下限は成り立つが、数値的には弱い。
| モデル | 層にわたる | 層の対 | 読み取り空間についての の最小値 Q / K / V | それが等方値を下回る層の対 Q / K / V |
|---|---|---|---|---|
| 124M | - | 66 | 0.084 / 0.084 / 0.048 | - |
| Qwen2.5-7B | - | 378 | 0.024 / 0.033 / 0.012 | 23 / 6 / 112 |
表 2. 読み取り空間を固定したときの最大の overlap の下限と実測値。
124M モデルでは、どの Q と K の読み取り空間も、前のすべての層のどれかの書き込み空間とおよそ等方値 0.083 以上に overlap している。Qwen2.5-7B では、前のある層のどの書き込み空間ともランダムな部分空間より弱くしか overlap しない読み取り空間があり、V で最も多い(等方値 0.036)。
学習済みモデルでの overlap
Setup
モデル
(a) 社内で学習した GPT-2 small と同じ形の 124M decoder(Radford et al., 2019)(内部の run 名「capacity-three baseline」: 12 層、12 ヘッド、、、pre-LayerNorm、1 epoch 65,536 ステップ; 層あたり 66 ヘッド対)。(b) Qwen2.5-7B(Qwen Team, 2024)、base と instruct(28 層、query ヘッド 28 と key-value ヘッド 4、、; 層あたり書き込み空間 378 対)。(c) Qwen3-235B-A22B(Qwen Team, 2025)の全 94 層(64 ヘッド、、; 層あたり 2016 対)。(d) Pythia-70m(Biderman et al., 2023)(6 層、8 ヘッド、、)。(b), (c) では必要なテンソルだけを取得した(BF16、FP64 で解析)。相対許容誤差 1e-6 で全ヘッドのランクは 128 であり、直和欠損 は次元により強制される分 を超えなかった。(a), (b) ではすべての は数値的に可逆であり、ヘッド幅の合計が ()の (c) では欠損 4096 は次元だけで強制される。読み取り空間は pre-attention のゲインと、(a) の LayerNorm では平均除去を折り込む。Qwen2.5-7B は grouped-query attention(GQA; Ainslie et al., 2023)を用いるので、各層の Q 読み取り空間は 28 個(378 ペア)だが K と V の読み取り空間は 4 個ずつ(各 6 ペア)である。
| モデル | ヘッド(query / key-value) | 層 | 層あたりの書き込み空間の対 | 等方値 | ||
|---|---|---|---|---|---|---|
| 124M baseline | 768 | 64 | 12 / 12 | 12 | 66 | 0.0833 |
| Qwen2.5-7B base | 3584 | 128 | 28 / 4 | 28 | 378 | 0.0357 |
| Qwen3-235B-A22B | 4096 | 128 | 64 / 4 | 94 | 2016 | 0.0313 |
| Pythia-70m | 512 | 64 | 8 / 8 | 6 | 28 | 0.125 |
表 3. モデルと等方値。
統計量と基準
各層で同種の空間の各非順序対 について と最小主角を計算し、層ごとに の平均、ペア上の標準偏差(これをばらつきと呼ぶ)、最小角を報告する。層をまたぐ書き手・読み手の対については、層 の書き込み空間と後の層 の読み取り空間のすべての対について同じ統計量を取る。 次元の独立な一様ランダム部分空間 2 つでは (124M モデルで 1/12、Qwen2.5-7B で 128/3584 = 0.0357、Qwen3-235B で 128/4096 = 0.0313)であり、これを等方値と呼ぶ。 の標準偏差は であり(Yamagiwa et al., 2026)、 で約 0.0017、 で 0.0024、 で 0.0003 である。このランダム部分空間基準は期待値であって下限ではない。
帰無モデル
学習済み は少数の方向にずっと強く書き込み、これもヘッド部分空間の間の角度に影響しうる。これを方向のヘッドへの割り当ての効果から切り分けるため、2 つの帰無モデルを用いる。スペクトル保存回転 は を ( は一様ランダムな直交行列)で置き換え、、したがってすべての特異値を保つが列は変える。列の再割り当て は学習済みの列の集合を保ち、ヘッドに分割する前に並べ替える。読み取り空間では積み重ねた読み取り行列に、層をまたぐ書き手・読み手の対では書き手と読み手にそれぞれ独立に適用する。各 30 サンプルを引いたのは、124M モデルの書き込み空間、124M モデルと Qwen2.5-7B の Q と K の読み取り空間、両モデルの層をまたぐ書き手・読み手の対である(FP64、ただし Qwen2.5-7B の層をまたぐ比較だけ FP32)。Qwen3-235B の層 46 は各 3 サンプルである。他の比較はランダム部分空間基準だけを用いる。
統計的な偏り
経験的片側 p 値は、 サンプルのうち観測以上に極端なものが 個のとき であり(Phipson and Smyth, 2010)、30 サンプルに対しては 1/31 = 0.032 以上である。ある層、あるいは層の対で、ペア間の のばらつきが両帰無モデルのすべてのサンプルを上回るとき、ヘッドの対の overlap は統計的に偏っているという。検定統計量は標準偏差であり、分布の形は分位点で別に述べる。30 サンプルでは報告できる最小の p 値は 1/31 であり、観測を再現する割り当てがないことを示すものではない。
分布の形: 少数の強い対と多数の弱い対
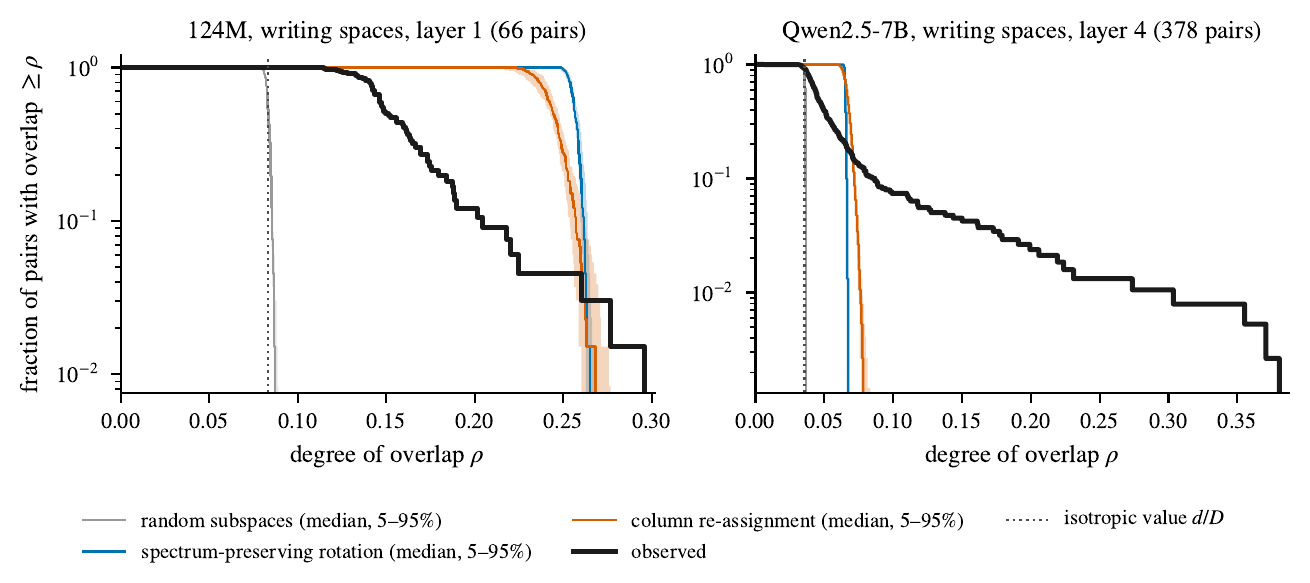
図 2. overlap の度合いが 以上である書き込み空間の対の割合(対数目盛)。各モデルの 1 層について示す。層は、層ごとのばらつきの上側中央値にあたる層として事前に固定した。黒は観測。色は各帰無モデルとランダム部分空間であり、30 サンプルのそれぞれで曲線を計算し、線はその中央値、帯は 5 - 95 パーセンタイルである。帯は帰無サンプル間の変動であって、観測の信頼区間ではない。点線は等方値 。データ: reports/pair-distributions/capacity-three-baseline-writing.json、reports/pair-distributions/qwen25-7b-writing-layer4.json。
図 2 は、124M モデルと Qwen2.5-7B のそれぞれ 1 層について分布全体を示す。ランダム部分空間と比べると、観測の対は等方値付近からその数倍まで広がる(124M の層 1: 中央値 0.150、95 パーセンタイル 0.248、最大 0.296。Qwen2.5-7B の層 4: 0.045、0.137、0.380)。帰無モデルと比べると、2 つの面がある。観測の対の大半は、どちらの帰無モデルが生んだどの対よりも弱く overlap する(124M の層で 66 対中 60、Qwen2.5-7B の層で 378 対中 270 が、列再割り当てのすべての値を下回る)。帰無モデルは の強い方向をすべてのヘッドに散らすからである。帰無のすべての値を超える右の裾は、Qwen2.5-7B でははっきりしている(378 対中 39 が列再割り当てのすべての値を上回る)が、124M の層では 1 対だけである。したがって 5.3 節の大きなばらつきは、分布の広がりから生じており、長い右の裾から生じるとは限らない。124M モデルの全 12 層では、観測の中央値は 11 層で帰無のすべてのサンプルの中央値を下回り、95 パーセンタイルは 8 層で帰無のすべてのサンプルの 95 パーセンタイルを上回る(Appendix E の図 7)。モデルごとの統計量は表 5(Appendix E)にある。
4 モデルの全層で、書き込み空間のペア平均 は等方値を 1.1 - 2.4 倍しか上回らない(124M で 1.4 - 2.1、Qwen2.5-7B で 1.1 - 2.1、Qwen3-235B で 1.1 - 2.4、Pythia-70m で 1.1 - 1.9)。一方、ばらつきはランダム部分空間基準の標準偏差の 11 - 31 倍(124M)、16 - 41 倍(Pythia-70m)、およそ 30 - 300 倍(Qwen モデル)である。典型的なペアの は等方値に近く、Qwen モデルで 0.03 - 0.06、124M モデルで 0.08 - 0.14 だが、最小主角は 25 - 66° あり、弱い overlap は が小さいことであって、すべての角が 90° に近いことではない。
分布は強い対からなる右の裾を持つ。Qwen2.5-7B の層 14 では、378 ペアの の中央値は 0.045、95 パーセンタイル 0.271、最大 0.537 であり、ペアの 31% が等方値の 2 倍を超え、0.3% が半分を下回る。Qwen3-235B の層 46(2016 ペア)では中央値 0.039、95 パーセンタイル 0.067、最大 0.392 であり、6.5% が等方値の 2 倍を超え、半分を下回るものはない。右の裾は各モデルでの例として報告するもので、すべての層の性質とは主張しない。Pythia-70m の層 3 の標準化三次モーメントはわずかに負である。ほぼゼロの角をなす対もある(Qwen2.5-7B 層 27 で 0.39°、Qwen3-235B 層 0 と 92 で 2.2° と 2.7°)。層の間では、最大の書き手・読み手の対は、124M モデルの層 5 の書き込み空間と層 6 の K 読み取り空間(、次いで 5 7 で 0.454、3 7 で 0.31、K)と、Qwen2.5-7B の層 23 の書き込み空間と層 27、26、25 の V 読み取り空間( 0.685、0.674、0.621)であり、ペア平均は等方値の近くにとどまる。その他の例は Appendix F に、スペクトル加重の尺度との比較は Appendix G にある。
帰無モデルとのばらつきの比較
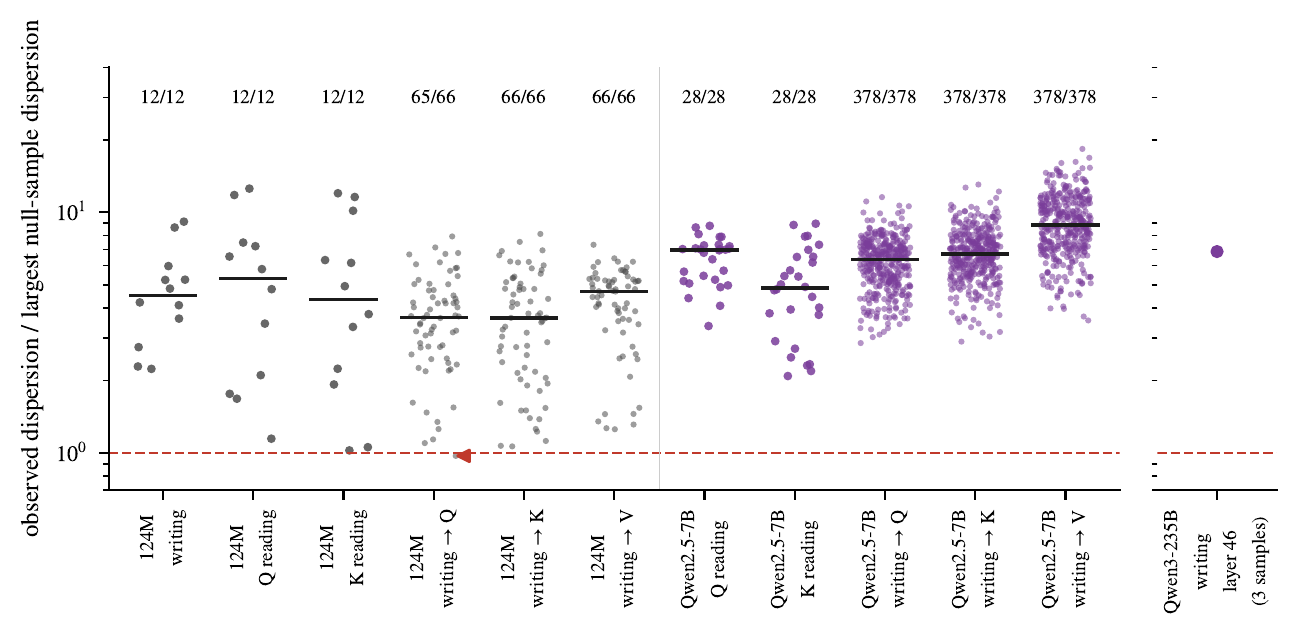
図 3. 帰無モデルとのすべての比較について、観測の のばらつきと、両帰無モデルの全サンプルのうち最大のばらつきとの比 (対数目盛)。各点は層(層内)または層の対(層間)であり、横棒は中央値、上の数字は の数である。破線は 。その下にある唯一の点(三角)は 124M の層 0 と層 3 の Q 読み取り空間の組で、 である。Qwen3-235B の層 46 は帰無サンプルが 3 つなので分けて示す。データ: 表 4 を参照。
| モデル | 比較 | 条件数 | 各帰無モデルのサンプル数 | 両方の全サンプルを上回る | の中央値 | 回転サンプルの平均に対する比の中央値 | 再割り当てサンプルの平均に対する比の中央値 |
|---|---|---|---|---|---|---|---|
| 124M | 書き込み空間、層内 | 12 | 30 | 12 | 4.5 | 11.8 | 5.7 |
| 124M | Q 読み取り空間、層内 | 12 | 30 | 12 | 5.3 | 11.3 | 6.7 |
| 124M | K 読み取り空間、層内 | 12 | 30 | 12 | 4.4 | 11.5 | 5.9 |
| 124M | 書き込み Q、層間 | 66 | 30 | 65 | 3.7 | 7.6 | 4.7 |
| 124M | 書き込み K、層間 | 66 | 30 | 66 | 3.6 | 6.8 | 4.4 |
| 124M | 書き込み V、層間 | 66 | 30 | 66 | 4.7 | 8.5 | 5.7 |
| Qwen2.5-7B | Q 読み取り空間、層内 | 28 | 30 | 28 | 7.0 | 31.5 | 8.1 |
| Qwen2.5-7B | K 読み取り空間、層内 | 28 | 30 | 28 | 4.8 | 20.9 | 8.2 |
| Qwen2.5-7B | 書き込み Q、層間 | 378 | 30 | 378 | 6.4 | 18.5 | 7.5 |
| Qwen2.5-7B | 書き込み K、層間 | 378 | 30 | 378 | 6.7 | 19.5 | 8.5 |
| Qwen2.5-7B | 書き込み V、層間 | 378 | 30 | 378 | 8.8 | 36.4 | 12.9 |
| Qwen3-235B-A22B | 書き込み空間、層 46 | 1 | 3 | 1 | 6.9 | 27.3 | 7.1 |
表 4. ばらつきの帰無モデルとの比較の要約。
図 3 と表 4 はすべての比較をまとめたものである。ばらつきは、124M モデルの 234 条件のうち 233、Qwen2.5-7B の 1,190 条件すべて、Qwen3-235B の 1 層で両帰無モデルのすべてのサンプルを上回り、最大の帰無サンプルに対する比 の中央値は 3.6 - 8.8 である。条件は重みや層を共有しているので独立な反復ではなく、そのうち 1,332 は層間の比較である。最大のサンプルに対する比はサンプル数に依存するので、Qwen3-235B は分けて示した。平均の向きは別の性質であり、層の対ごとに図 9(Appendix F)に示す。Qwen2.5-7B の書き込み空間の帰無サンプルはまだない。
書き込み空間
124M モデルで観測されたばらつきは層あたり 0.019 - 0.053 であり、スペクトル保存回転の 0.0024 - 0.0037(30 サンプルの最大 0.0048)と列再割り当ての 0.0036 - 0.0101(最大 0.0155)に対し、全 12 層ですべての帰無サンプルを上回る(24 比較中 24)。回転に対する比は 5 - 20 倍である。Qwen3-235B の層 46 では 0.0171 に対し 0.0006 と 0.0024 である。平均は逆向きに動く。124M モデルの 12 層中 11 層で、平均は両帰無モデルの 30 サンプルすべてを下回る(0.126 - 0.306 と 0.123 - 0.268; 例外は層 7 で 0.134 vs 0.128 / 0.133)。学習済み は少数の方向に強く書き込み(先頭特異値 2.7 と 1.9 に対しバルクは 0.3 - 0.6)、これはランダムな割り当ての平均の overlap を押し上げるが、学習された割り当ての overlap はそれより小さい。Qwen3-235B の層 46 も同じ方向を示す(0.043 vs 0.058 と 0.055、)。ペア全体の最小角は全 12 層で回転の全サンプルを下回る(観測 8.8 - 38.3° vs 14.7 - 49.7°)が、列再割り当てに対しては 6 層で全サンプルを下回らない(Appendix E)。学習済みの列を並べ替えるだけでもほぼ平行な 2 本の列が別のヘッドに入りうるので、強い単一の対は学習された割り当てに固有ではない。固有なのはばらつきである。
読み取り空間
Q と K の読み取り空間も同じ統計的な偏りを示す。ランダム部分空間基準は , で (100 サンプル)、Qwen2.5-7B で である。
ばらつきは 124M モデルの Q, K で全 12 層(48 比較中 48)、Qwen2.5-7B で全 28 層(112 比較中 112)で両帰無モデルの全サンプルを上回る。帰無サンプルは 124M モデルで 0.0051(回転)と 0.0175(再割り当て)、Qwen2.5-7B で 0.0023 / 0.0036(回転、Q / K)と 0.0132 / 0.0248(再割り当て)を超えない。Qwen2.5-7B の K の統計量は層あたり 6 ペアに基づく。層ごとの値は表 7 に、詳細は Appendix F にある。
層をまたぐ書き手・読み手の対
この比較は、異なる層のヘッドが通信する対を扱う。層の各対 と読み取りの各種類について、書き手・読み手のヘッド対(124M モデルで 144、Qwen2.5-7B で 784(Q)または 112(K, V))にわたる のばらつきを帰無サンプルと比べた。
ばらつきは 124M モデルの 198 条件のうち 197 で、Qwen2.5-7B の 1,134 条件すべてで、両帰無モデルのすべてのサンプルを上回る。唯一の例外である 124M モデルの層 0 と層 3 の Q 読み取り空間の組では、ばらつき 0.00189 に対し列再割り当てのサンプルの最大値は 0.00194 である()。読み取りの種類ごとの値は表 8(Appendix F)にある。Qwen2.5-7B では、ばらつきは 0.0015 - 0.035(Q)、0.0016 - 0.037(K)、0.0018 - 0.124(V)であり、回転のサンプルは最大でも 0.0009、再割り当てのサンプルは最大でも 0.0049、0.0050、0.0114 である。回転のサンプル平均に対する比は 4 - 57、4 - 84、5 - 227 である。平均は読み取りの種類と距離に依存し、Q と K は前の層の書き込み空間とランダムな割り当てより弱く、V はそれより強く overlap することが多い。
実際の活性での射影
Section 4.2 の 2 つの経路を、124M モデルで FineWeb-Edu(Penedo et al., 2024)の検証データ 2,048 トークン(256 トークンの窓 8 個)について測った。各層 の各ヘッド と、より後の各層 の各ヘッド について、ヘッド の実際の書き込み と層 に入る残差 を取り、ヘッド の Q, K, V 読み取り写像について線形項、正規化項、その和 を計算し、二乗ノルムをトークンで平均した(読み取りの種類ごとに 9,504 ペア)。これは直接残差経路の一次応答であり、ヘッド がヘッド に与える総効果ではない。
典型的なペアでは、線形項と応答全体のエネルギーは近い。線形項の平均二乗ノルムと応答全体のそれとの比のペア中央値は 1.016(Q)、1.011(K)、1.004(V)であり(5 - 95 パーセンタイルは 0.99 - 1.09、0.90 - 1.21、0.97 - 1.04)、正規化項を 、全体を とした相対 RMS 誤差 の中央値は 10.2%、14.6%、9.5% である。正規化項のエネルギーは線形項の 5.6 - 6.8% である(全ペアの合計で Q 6.8%、K 5.6%、V 6.0%; 中央値の対で 1.0%、2.0%、0.9%)。全ペアの合計では、全体のエネルギーは線形項より Q で 12%、K で 33% 小さく、V では 1% 大きい。交差項はこの標本では負だが、9,504 ペア中 Q で 441、K で 510、V で 395 ペアでは正であり、一般には符号は定まらない。
書き込みの二次モーメントを とすると、読み取り空間に射影されるエネルギーの割合は
であり、 が 上で等方的なら に一致し、それ以外の書き込みでは と の間にある(Section 4.2)。これは と Spearman 0.77(Q)、0.75(K)、0.72(V)で相関する(Pearson 0.67、0.51、0.66; との比の中央値 1.18、1.17、0.96)。読み手の応答の大きさはさらに読み取り写像と書き込みにもよる。線形項の二乗ノルムは と Q で 0.74、K で 0.65 の相関を持つが、V では相関しない(0.03)。1 つの層の対の中では、その 144 ヘッド対にわたる相関は、66 組の層の対の中央値で 0.82(Q)、0.69(K)、0.67(V)であり、K と V でそれぞれ 1 組の層の対ではわずかに負である(Appendix D の図 5)。実測の割合と の比の 5 - 95 パーセンタイルは 0.90 - 2.21(Q)、0.89 - 2.84(K)、0.50 - 1.55(V)である。 は対を順位づけるが、個々の対の割合を精密には予測しない(図 4)。合成スコア(Elhage et al., 2021)は と Spearman 0.67(Q)、0.63(K)、0.79(V)で相関する(Pearson 0.47、0.24、0.66)。合成スコアは特異値と内部方向の対応も反映し、正規化を折り込まない重みから計算される。データ: reports/read-paths/capacity-three-baseline-read-paths-v2.json(lm/wo_read_paths.py)。
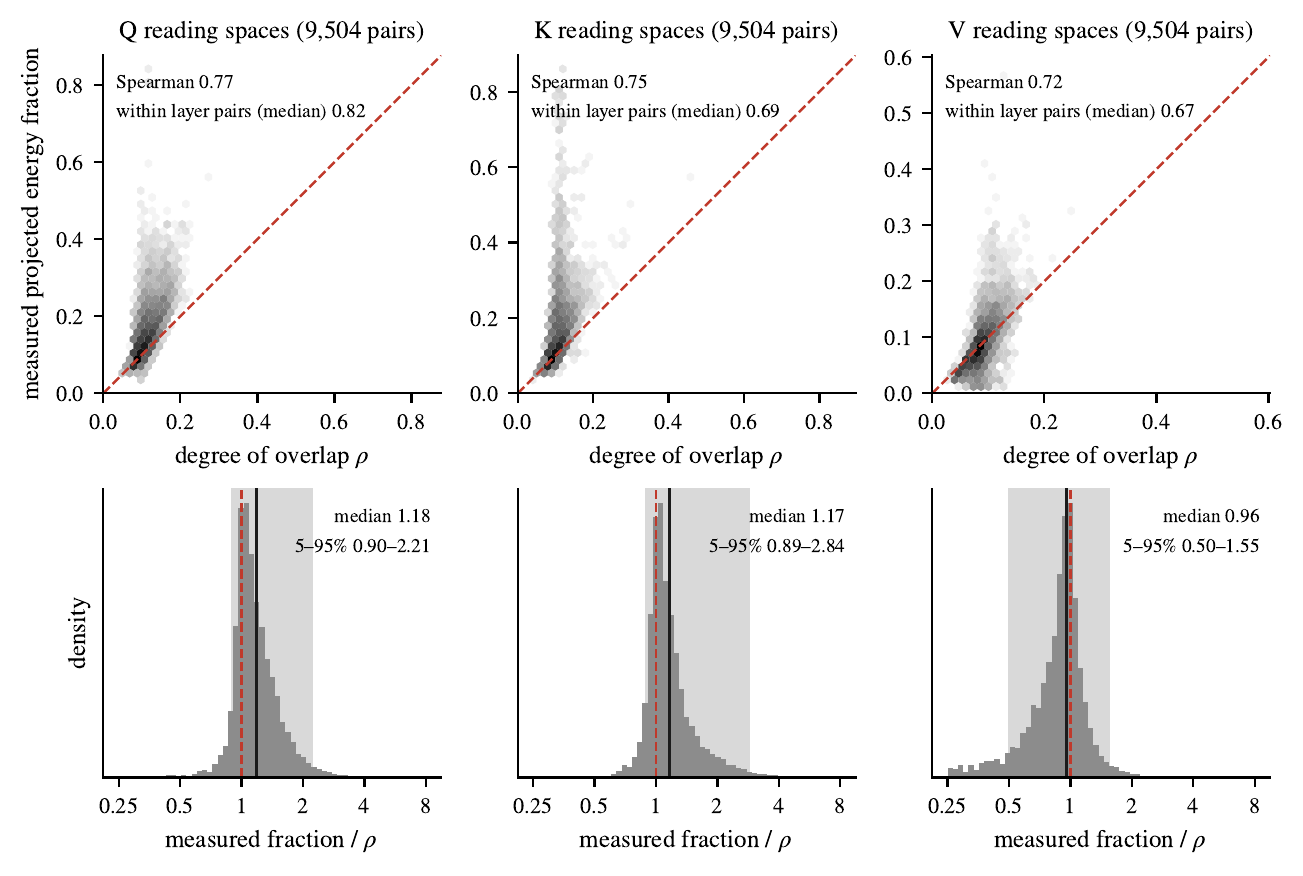
図 4. 上: 124M モデルの読み取りの種類ごとに、書き手・読み手のヘッド対 9,504 組すべてについて、実際の書き込みの実測射影エネルギー割合 と (六角ビン、個数は対数)。破線の対角線は等方的な書き込みでの値である。下: 実測の割合と の比の分布(対数目盛)。中央値(実線)、5 - 95 パーセンタイル(網掛け)、比 1(破線)を示す。実測の割合は読み手の応答の大きさではない(図 5)。
V 読み取り空間、自ヘッドの overlap、instruction tuning
V 読み取り空間(Qwen2.5-7B)
6 つの層(0, 7, 9, 18, 19, 21)では V 読み取り空間どうしの平均 は 0.015 - 0.030、すなわち等方値の 0.4 - 0.8 倍、基準の標準偏差で 20 - 60 個分下である(ランダム部分空間基準との比較)。最後の 2 層は逆である(0.404 と 0.717)。
自ヘッドの overlap(124M)
層内のヘッドで平均すると、ヘッドの V 読み取り空間は他ヘッドの書き込み空間より自分の書き込み空間と強く overlap する(0.099 - 0.373 vs 0.070 - 0.108、置換検定の が全層)。これは部分空間レベルの統計量であり、それだけではコピーを示さない(Appendix H)。
instruction tuning(Qwen2.5-7B)
base と instruct では、o_proj テンソルは異なるが、書き込み空間どうしの overlap の度合いはペアごとに一致する(10,584 ペアで絶対差最大 、相対差最大 0.53%)。 は共通の回転で変わらないので、これは個々の空間が同じ位置に留まったことを示さない。
Discussion
1 つの層の中では、ヘッド幅の合計が残差ストリームの次元に等しければ書き込み空間がほぼ常に残差ストリームを直和分解し、ヘッド部分空間は一般に disjoint なので、線形経路ではヘッドは非直交な overlap を通してしか通信できない。実際の活性では、書き込みの射影割合は順位の上で overlap の度合いと相関し、overlap の度合いは直接経路で書き込みのどれだけが各読み取り空間に入るかをおおよそ示す。
配置が選択的に学ばれていることの根拠
帰無モデルは学習済み行列の特異値と 、あるいは列の集合を保ち、どの方向がどのヘッドに属するかだけを変える。観測された overlap のばらつきは、124M モデルの書き込み空間と、124M モデルと Qwen2.5-7B の Q, K の読み取り空間について、調べたすべての層で各帰無モデルの 30 サンプルすべてを超え(層ごとに片側 )、層をまたぐ比較では 124M モデルで 198 中 197、Qwen2.5-7B で 1,134 すべてで超える。ばらつきの結果はほぼすべての比較に共通するが、平均の向きはそうではない(124M の書き込み空間の層 7 と Q, K の中間層が例外であり、層間では V の平均は帰無モデルを上回ることの方が多い)。どの対がどれだけ強く overlap するかは、帰無モデルから得たランダムな割り当てが生むものとは大きく異なる。ただし、それが何のための配置かは特定しない。
仮説
1 層の書き込み空間について とすると なので、書き込み空間の overlap は、ヘッドが残差ストリームの方向をどれだけ不均一に覆うかを測る(直交するときちょうど )。あらゆる読み手は正規化を通して残差ストリームを見るので、ヘッド出力にノルムの制約がある場合、少数の強く overlap する対と多数の弱く overlap する対からなる配置は、分離可能性を少し手放して、共に覆う方向へ複数のヘッドが効率よく寄与できるようにしている、と推測する。検証には、その制約、ヘッドが作る活性、PK が捨てる符号の情報が必要である。
限界と今後の課題
PK は重みの性質であり、符号、部分空間内の回転、特異値、使われ方を無視する。自ヘッドの overlap や強い対だけではコピーや強化は示せない。活性の解析は一次かつ局所的で、124M モデルに限られる。書き込み空間の帰無サンプルは 124M モデルと Qwen3-235B の 1 層にしかなく、読み取り空間の解析は 2 つのモデルが対象である。残差ストリーム全体を読み書きする MLP は解析していない。今後は、仮説を活性で検証し、方向を使われ方で重み付けし、Qwen の書き込み空間の帰無比較を完成させる。 を単位行列や直交基底に固定したアーキテクチャ(124M と 405M で学習済み)は別途報告する。
Conclusion
attention ヘッドの読み取り空間と書き込み空間は、重みが定める写像の核の直交補空間と像として内在的に定義でき、この定義はあらゆる読み取りが読み取り空間への射影を通ることを明示する。ほとんどすべての重みについて、ヘッド幅の合計が残差ストリームの次元に等しければ 1 層の書き込み空間は残差ストリームを直和分解し、任意の 2 つのヘッド部分空間は disjoint である。したがって disjoint 性はヘッドを分け隔てない。分け隔てるのは直交性だが、すべての対が直交することはできない。一部の対は必ず非直交であり、disjoint な部分空間も射影を通して相互作用し、その大きさを PK は鋭く上から抑え、平均では正確に与える。PK で測ると、学習済みモデルは強い非直交性を少数のヘッド対に集中させており、その程度は同じ重みのランダムな割り当てをはるかに超える。これは、どの部分空間をどれだけ強く通信させるかを学習が選んでいることを示唆する。この配置が何のためにあり、正規化とどう関わるかは今後の検証課題である。
付録
付録 A: 読み取り空間と書き込み空間
Section 3 の命題の証明。 (, )と分解すると であり、 のベクトルで零に写るものは核にも入るので零である。よって制限は単射である。書き込みについての主張は像の定義そのものである。制限は像への可逆な線形写像である(フルランクのヘッドなら への写像)。これらの空間は任意の可逆行列 について , および , で不変である。
本稿と Yamagiwa et al. (2026) が用いる行列規約では、、、、 の列空間は 、、、 である。 の非零特異値に対応する左特異ベクトルは、 が行フルランクなら を張り、右特異ベクトルは、 が列フルランクなら を張る。 については、 が行フルランクなら 、 が行フルランクなら が得られる。構成が食い違うのは、ランク落ちのヘッドか、上位の特異ベクトルだけを残す場合だけである。
付録 B: 直和分解と disjoint 性
Section 4.1 の命題の証明。 (a) 和が 次元部分空間の直和であることは と同値である。これが破れるのはちょうど の最大小行列式の二乗和( なら )の零点集合であり、これは成分の非零多項式なので Lebesgue 測度零である。積み重ねた読み取り行列 にも同じ議論が当てはまる。成分が離散的な行列では問題はより微妙である(Tao and Vu, 2007)。(b) のとき、共通の非零方向を持つ部分空間の対の集合は Grassmann 多様体の積の中で正の余次元を持ち(横断性)、したがって測度零である。直交性も一般的ではない。 のとき、書き込み空間が互いに直交することは が ブロックのブロック対角であることと同値であり、これは 本の多項式方程式の系である。 を単位行列にすると直交配置
が得られるが、読み取り空間が複数のブロックと非直交な後の層の読み手はそれらすべてを受け取る。線形経路での通信の不在は、書き込み空間だけでなく書き手と読み手についての条件 である。
付録 C: 最大の overlap の下限
Section 4.3 の命題の証明。 なので である。 個の項の最大値はその平均以上であり、 である。正規直交基底を並べた について なので、 は の最小特異値の二乗であり、 が を張るので正である。 が部分空間 しか張らない場合でも、 なら はどれかの と非直交である。そうでなければ となるからである。 が直交分解なら なので、直交配置では であり、 のとき下限は である。
付録 D: 線形経路と正規化経路
Section 4.2 の式は のヤコビアンを に作用させ、 と合成したものである。2 次元で RMSNorm(ゲイン 1、)、読み手 とし、 に読み取り空間に直交する書き込み を加えると、 にもかかわらず読み手の値は 1 から に変わる。 のとき、 の単位書き込みは の特異値である から の間のノルムで に射影され、 である。
Section 4.2 の命題(PK は伝達量を抑える)の証明。 の最大特異値は なので、 のあらゆる単位ベクトル について である。さらに 、 である。したがって上限は 以下である。 なら主角は の任意の値に選べるので、次のように選べば上限が達成される。 なら とし、他の角をすべて 90° とする。()なら とし、 を残り 個の に分ける。平均については、 から等方的に引いた単位ベクトルは を満たすので、 のとき である。 は の平均以上なので である。
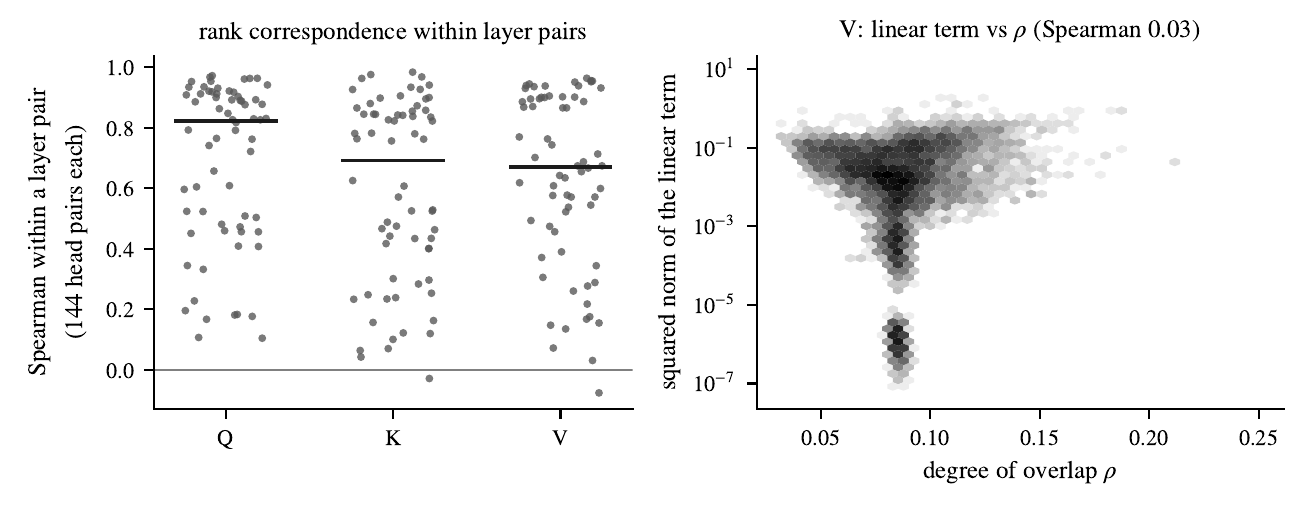
図 5. 左: 124M モデルの各層の対の 144 ヘッド対にわたる、 と実測射影エネルギー割合の Spearman 相関(読み取りの種類ごとに 66 組、横棒は中央値)。右: V 読み取り写像の線形項の平均二乗ノルムと (Spearman 0.03)。射影される割合と、読み取り後の応答の大きさは異なる。
付録 E: 書き込み空間の補足
4 モデルの書き込み空間の統計量を表 5 にまとめる。
| モデル | ヘッド | 層 | 等方値 | 書き込み空間のペア平均 (層中央値、範囲) | ばらつき(中央値、範囲) | ランダム部分空間基準の SD | 10° 未満のペアがある層 | ||
|---|---|---|---|---|---|---|---|---|---|
| 124M baseline | 768 | 64 | 12 | 12 | 0.0833 | 0.135 (0.114 - 0.176) | 0.033 (0.019 - 0.053) | 0.0017 | 2 |
| Qwen2.5-7B base | 3584 | 128 | 28 | 28 | 0.0357 | 0.059 (0.038 - 0.077) | 0.043 (0.021 - 0.106) | 0.0004 | 7 |
| Qwen3-235B-A22B | 4096 | 128 | 64 | 94 | 0.0313 | 0.054 (0.036 - 0.074) | 0.033 (0.010 - 0.083) | 0.0003 | 9 |
| Pythia-70m | 512 | 64 | 8 | 6 | 0.125 | 0.195 (0.141 - 0.235) | 0.071 (0.039 - 0.098) | 0.0024 | 4 |
表 5. 1 層の書き込み空間どうしの overlap の度合いの平均とばらつき。
観測の最小角が列再割り当てのすべてのサンプルを下回らない層:
| 層 | 観測の最小角(度) | 列再割り当てサンプルの最小角の最小値(度) |
|---|---|---|
| 1 | 9.745 | 6.130 |
| 2 | 25.196 | 18.909 |
| 3 | 14.293 | 8.188 |
| 4 | 38.343 | 28.530 |
| 5 | 34.361 | 33.655 |
| 11 | 20.281 | 13.218 |
表 6. 観測の最小角が列再割り当てのすべてのサンプルを下回らない 124M モデルの層。
Qwen3-235B では平均は 0.05 付近に留まるが、ばらつきは最後の 3 分の 1 でおよそ倍増し(層 60 - 93: 0.04 - 0.08 vs 層 20 - 50: 0.02 - 0.03)、小さい最小主角は最初の 3 層と最後の 3 層に集中する。Qwen2.5-7B も同じ後半層での上昇を示す(層 18 - 27 にばらつき上位 5 層が含まれる)。base と instruct は層ごとの統計量が小数点以下 3 - 4 桁まで一致する(層 14 で平均 0.0767 / 0.0767、ばらつき 0.0821 / 0.0821、最小角 21.91 / 21.91°; 絶対差の中央値 )。
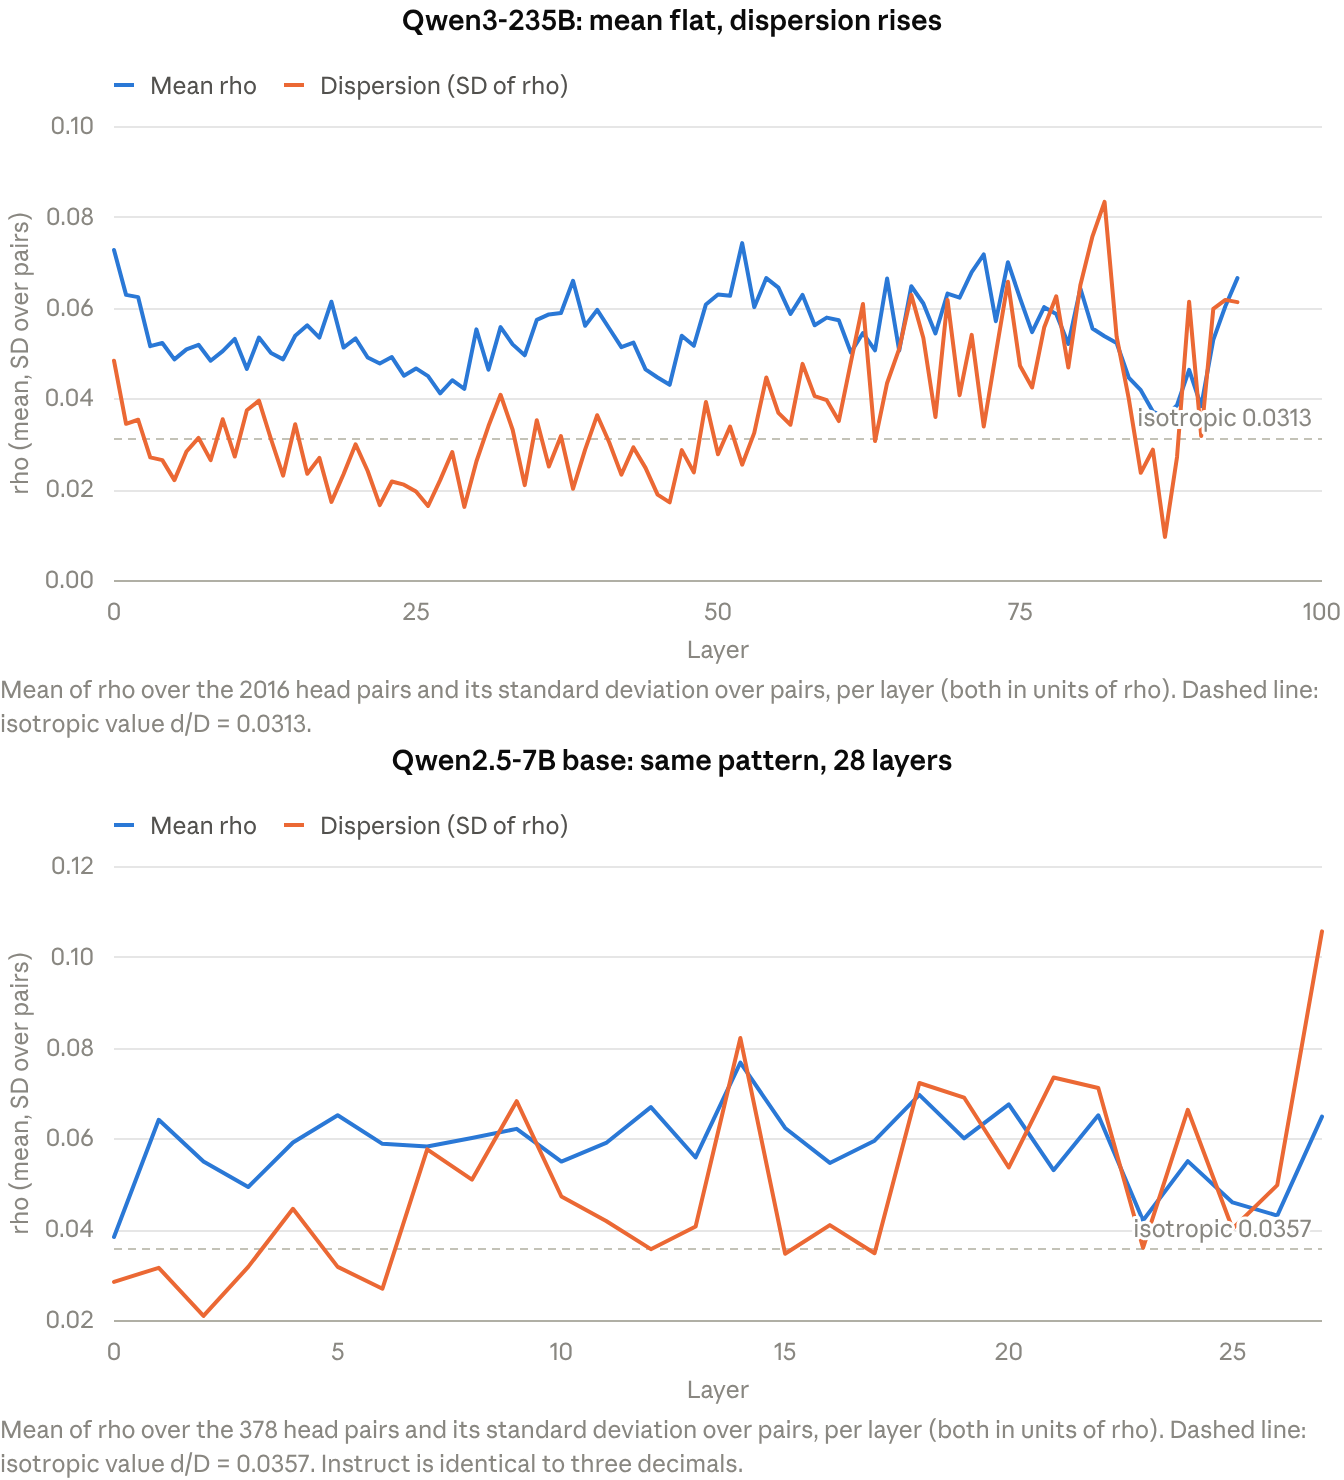
図 6. 書き込み空間ペアにわたる overlap の度合いの平均とばらつきの深さ方向プロファイル(上: Qwen3-235B-A22B 94 層、下: Qwen2.5-7B base 28 層、観測のみ)。両モデルとも平均は等方値の 2.4 倍以内に留まり、ばらつきはランダム部分空間基準の標準偏差の 30 - 300 倍で最終層に向けて増大する。データ: reports/wo-spark-all94-02XVEgdF、reports/qwen25-7b-pair-6wgSVtY8。
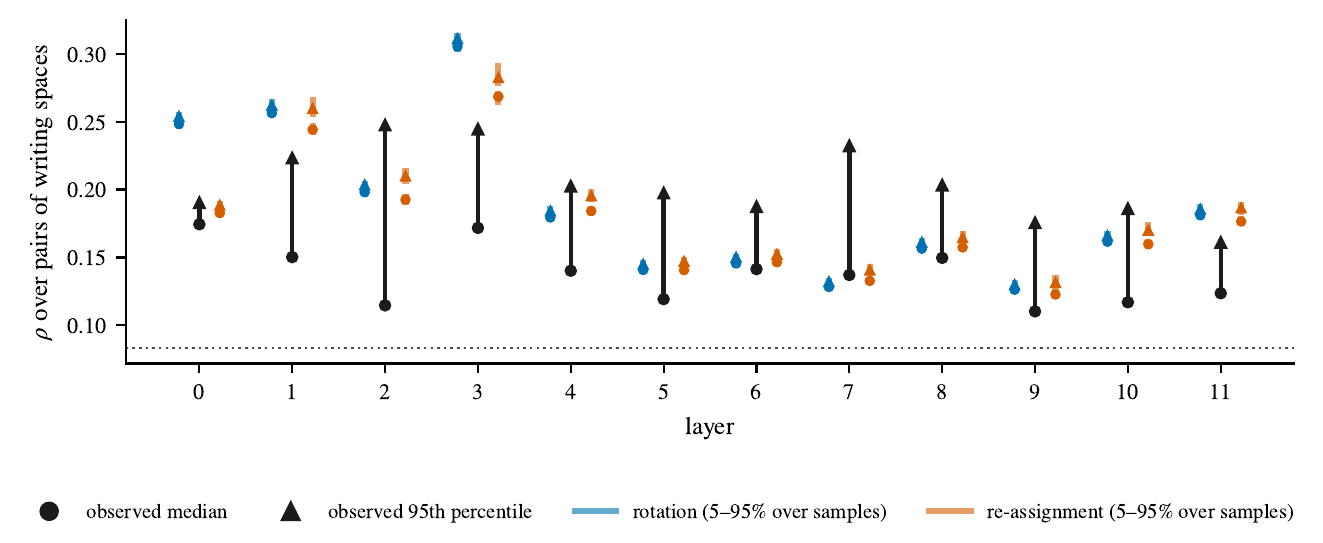
図 7. 124M モデルの 66 対の書き込み空間についての、層ごとの の中央値(丸)と 95 パーセンタイル(三角)(黒)。各帰無モデルについては、30 サンプルの同じ分位点の 5 - 95 パーセンタイル(色の棒)を示す。点線は等方値。他の比較の同じ要約は、ペアごとの帰無サンプルを再計算した後に加える。データ: reports/pair-distributions/capacity-three-baseline-writing.json。
付録 F: 読み取り空間と書き手・読み手の対の補足
124M モデルでは、Q と K の読み取り空間の平均の overlap は大半の層で両帰無モデルを下回る(回転帰無モデルの平均は Q で 0.20 - 0.38、K で 0.19 - 0.42)が、中間層の連続したブロックではより強く overlap する。V の読み取り空間は最も均等に overlap し、ペアの最小角の平均は Q で 21.9 - 39.3°、K で 14.2 - 40.5°、V で 41.4 - 50.8°、書き込み空間で 24.3 - 48.7° である。Qwen2.5-7B では、Q のばらつきは基準の標準偏差の 60 - 270 倍、Q と K の平均 overlap は等方値の 1.8 - 7.6 倍と 1.5 - 9.2 倍である(Q の回転帰無モデルの平均 0.089 - 0.347)。Q の最小角は全 28 層で回転の全サンプルを下回り、K では 17 層で回転の全サンプルを下回り、8 層で全サンプルを上回る。読み取り空間は書き込み空間より強く overlap する(中央値の層で Q は等方値の 3.0 倍、O は 1.65 倍)。層 1 は極端であり(平均 0.271、最小角の平均 9.4°、最小角 1.4°)、最後の 2 層の Q 読み取り空間の平均 は 0.169 と 0.209 である。124M モデルでは 2 つの K 読み取り空間が層 4 で 3.9°、層 2 で 6.7° をなす。 Qwen2.5-7B の V の 6 層の最小角の平均は 50 - 72° であり、層 27 は 9.8° である。
| モデル | 読み取り空間 | 層あたりペア数 | 平均 (層の範囲) | 平均が両帰無モデルの全サンプルを下回る層 | ばらつき(範囲) | ばらつきが両帰無モデルの全サンプルを上回る層 | ペア全体の最小角(度) |
|---|---|---|---|---|---|---|---|
| 124M | Q | 66 | 0.145 - 0.221 | 12 層中 8(層 6 - 9 は上回る) | 0.012 - 0.082 | 12 層中 12 | 6.1 |
| 124M | K | 66 | 0.136 - 0.211 | 12 層中 10(層 7, 9 は上回る) | 0.013 - 0.087 | 12 層中 12 | 3.9 |
| 124M | V | 66 | 0.114 - 0.180 | - | 0.016 - 0.048 | - | 21.3 |
| Qwen2.5-7B | Q | 378 | 0.066 - 0.271 | 28 層中 28 | 0.021 - 0.093 | 28 層中 28 | 1.4 |
| Qwen2.5-7B | K | 6 | 0.054 - 0.329 | 28 層中 28 | 0.016 - 0.118 | 28 層中 28 | 6.1 |
| Qwen2.5-7B | V | 6 | 0.015 - 0.717 | - | 0.003 - 0.395 | - | 7.4 |
表 7. 層内の同種の読み取り空間どうしの overlap の度合いと帰無モデルとの比較。
| モデル | 読み取り | 層の対 | ばらつきが両帰無モデルの全サンプルを上回る | 回転帰無モデルに対するばらつきの比の中央値 | 平均が両方の全サンプルを下回る | 平均が両方の全サンプルを上回る |
|---|---|---|---|---|---|---|
| 124M | Q | 66 | 65 | 7.6 | 40 | 15 |
| 124M | K | 66 | 66 | 6.8 | 36 | 19 |
| 124M | V | 66 | 66 | 8.5 | 10 | 39 |
| Qwen2.5-7B | Q | 378 | 378 | 18.5 | 242 | 36 |
| Qwen2.5-7B | K | 378 | 378 | 19.5 | 153 | 72 |
| Qwen2.5-7B | V | 378 | 378 | 36.4 | 81 | 148 |
表 8. ある層の書き込み空間と後の層の読み取り空間の間の overlap の度合いのばらつきと帰無モデルとの比較。
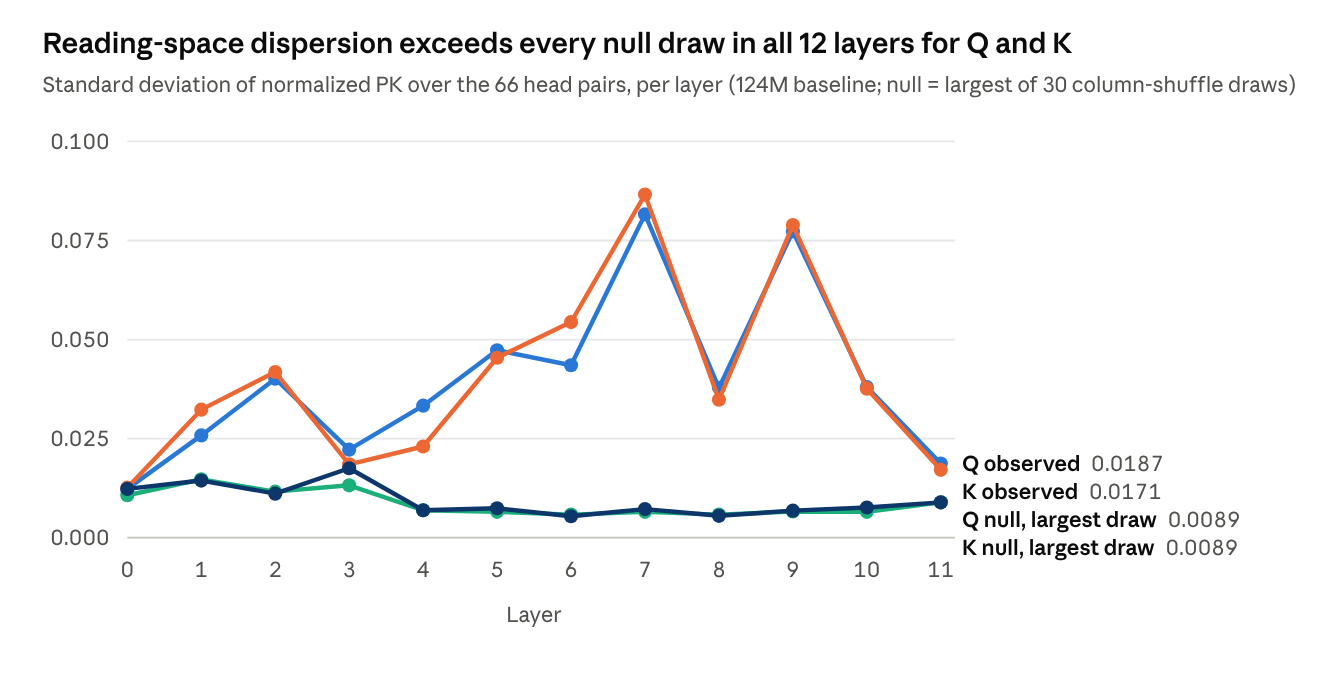
図 8. 124M baseline の Q と K の読み取り空間についてのペア間の overlap の度合いのばらつき(層ごと)と、30 本の列再割り当てサンプルの最大値。回転のサンプルは 0.0051 を超えない。データ: reports/read-geometry/capacity-three-baseline.json。
124M モデルでは、書き手・読み手の対のペア平均 は層差 とともに減衰する。層差 1 で 0.115(Q)、0.104(K)、0.091(V)であり、層差 9 以上では 3 つとも 0.083 の <!-- -->{=html}0.01 以内に収まる。Qwen2.5-7B では層差 1 での平均は 0.047 - 0.048(等方値の 1.3 倍)で、Q と K は層差およそ 10 で等方値まで減衰する。V は層差 7 - 18 で等方値を下回る(0.029 - 0.035)。Q の平均は、層差 3 以下の 78 組の層の対のうち 63 組、層差 10 超の 153 組のうち 66 組で両帰無モデルのすべてのサンプルを下回り、V の平均は層差 10 超の 153 組のうち 77 組で全サンプルを上回り、下回るのは 20 組だけである。層 24 - 27 の V 読み取り空間に対して、層 23 の書き込み空間は 0.55 - 0.69、層 3 の書き込み空間は層 25 - 27 に対して 0.51 - 0.56(層 27 と 0.563)に達する。Q の最大は 0.386(23 27)、K の最大は 0.297(21 22)である。
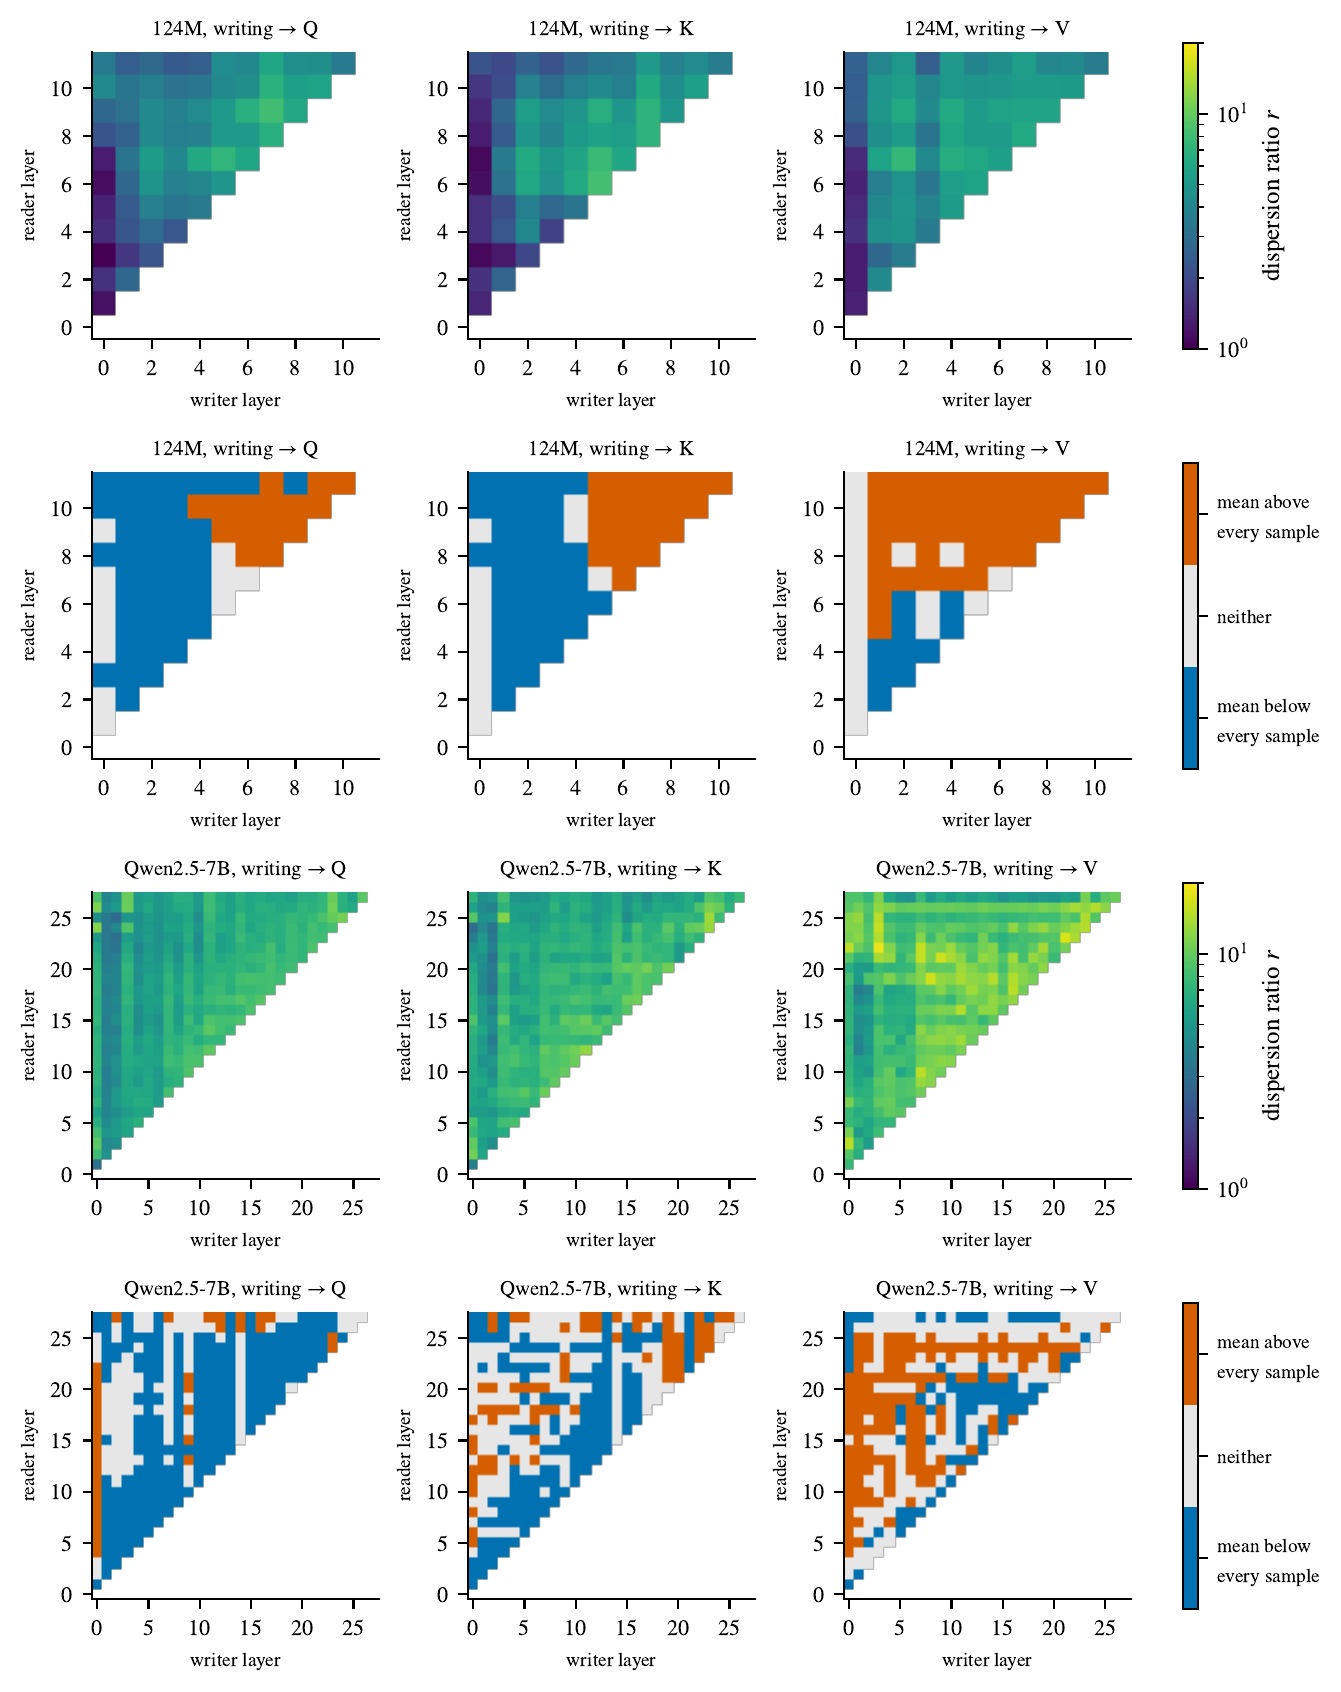
図 9. 書き手の層と後の読み手の層の各対、読み取りの各種類について、観測のばらつきと最大の帰無サンプルのばらつきの比 (1 行目と 3 行目)、および平均 が両帰無モデルのすべてのサンプルを下回るか、上回るか、どちらでもないか(2 行目と 4 行目)。データ: reports/read-geometry/capacity-three-baseline-cross-nulls.json、reports/read-geometry/qwen25-7b-base/qwen25-7b-base-cross-nulls.json。
付録 G: スペクトル加重の尺度
ヘッド対の正規化を折り込んだ読み取り行列 と書き込み行列 について、 は独立なガウス行列でおよそ 1 であり、 と違って特異値に依存する。その最大値は とは別の層の対で現れる。以下の値は各層の対のヘッド対にわたる最大値であり、 の最大値と同じヘッド対とは限らない。
| モデル | 層の対、読み取り種別 | の最大値 | 加重尺度の最大値 |
|---|---|---|---|
| 124M | 5 6, K | 0.598 | 10.4 |
| 124M | 5 7, K | 0.454 | 7.5 |
| 124M | 1 2, K | 0.225 | 130.8 |
| 124M | 1 4, K | 0.191 | 123.7 |
| Qwen2.5-7B | 23 27, V | 0.685 | 20.9 |
| Qwen2.5-7B | 13 14, K | 0.283 | 56.6 |
表 9. 層の対ごとの overlap の度合いの最大値とスペクトル加重の尺度の最大値。
加重尺度のヘッド対にわたる平均は、124M モデルの層の対で 0.63 - 14.51(中央値 1.35)、Qwen2.5-7B で 0.37 - 3.08(中央値 1.13)である。
付録 H: 自ヘッドの overlap
124M モデルでは、各層で をヘッドで平均し、書き込み空間のラベルを置換した場合の同じ平均と比べた(10,000 置換)。0.099 - 0.373 vs 0.070 - 0.108(等方値 0.083)で全層 であり、層 0 - 4 では 0.20 - 0.37 である。ヘッドの Q と K の読み取り空間も他ヘッドのものより互いに強く overlap し(0.15 - 0.34 vs 0.12 - 0.17、)、Q 読み取り空間は自分の書き込み空間とわずかに強く overlap するだけである(0.10 - 0.16 vs 0.09 - 0.13、)。PK は符号を無視するので( でも値は同じ)、これはコピーを示さない(cf. Feng and Li, 2026)。Qwen2.5-7B では、各 query ヘッドの書き込み空間を自分の key-value グループの V 読み取り空間と比較し、4 グループのラベルの 24 通りの置換と対照した(p の最小値 1/24 = 0.042)。0.044 - 0.285 vs 0.026 - 0.110 で、28 層中 27 で p は最小値(層 26: 0.083)であり、層 7, 9, 18, 21 で最も強く(0.24 - 0.28)、層 0 で弱く(0.044)、層 19 で中程度(0.181)である。Q 読み取りと自グループの K 読み取りは全 28 層で他グループより強く()、Q 読み取りと自分の書き込み空間の平均は 0.039 - 0.115 vs 0.034 - 0.075 である(、28 ヘッド、10,000 置換)。
References
Joshua Ainslie, James Lee-Thorp, Michiel de Jong, Yury Zemlyanskiy, Federico Lebrón, and Sumit Sanghai. 2023. GQA: Training generalized multi-query transformer models from multi-head checkpoints. In Proceedings of the 2023 Conference on Empirical Methods in Natural Language Processing, pages 4895–4901. doi:10.18653/v1/2023.emnlp-main.298.
Jimmy Lei Ba, Jamie Ryan Kiros, and Geoffrey E. Hinton. 2016. Layer normalization. arXiv preprint arXiv:1607.06450.
Stella Biderman, Hailey Schoelkopf, Quentin Gregory Anthony, Herbie Bradley, Kyle O'Brien, Eric Hallahan, Mohammad Aflah Khan, Shivanshu Purohit, USVSN Sai Prashanth, Edward Raff, Aviya Skowron, Lintang Sutawika, and Oskar van der Wal. 2023. Pythia: A suite for analyzing large language models across training and scaling. In Proceedings of the 40th International Conference on Machine Learning, volume 202 of Proceedings of Machine Learning Research, pages 2397–2430. arXiv:2304.01373.
Åke Björck and Gene H. Golub. 1973. Numerical methods for computing angles between linear subspaces. Mathematics of Computation, 27(123):579–594. doi:10.1090/S0025-5718-1973-0348991-3.
Nelson Elhage, Tristan Hume, Catherine Olsson, Nicholas Schiefer, Tom Henighan, Shauna Kravec, Zac Hatfield-Dodds, Robert Lasenby, Dawn Drain, Carol Chen, Roger Grosse, Sam McCandlish, Jared Kaplan, Dario Amodei, Martin Wattenberg, and Christopher Olah. 2022. Toy models of superposition. Transformer Circuits Thread. https://transformer-circuits.pub/2022/toy_model/index.html; arXiv:2209.10652.
Nelson Elhage, Neel Nanda, Catherine Olsson, Tom Henighan, Nicholas Joseph, Ben Mann, Amanda Askell, Yuntao Bai, Anna Chen, Tom Conerly, Nova DasSarma, Dawn Drain, Deep Ganguli, Zac Hatfield-Dodds, Danny Hernandez, Andy Jones, Jackson Kernion, Liane Lovitt, Kamal Ndousse, Dario Amodei, Tom Brown, Jack Clark, Jared Kaplan, Sam McCandlish, and Chris Olah. 2021. A mathematical framework for transformer circuits. Transformer Circuits Thread. https://transformer-circuits.pub/2021/framework/index.html.
Jiming Feng and Junliang Li. 2026. Scaled idempotence in transformer attention: Paired OV geometry and shared-value algebras. arXiv preprint arXiv:2609.01129.
Ernest Fokoué. 2026. Multi-head attention as ensemble Nadaraya-Watson estimation: Variance reduction, decorrelation, and optimal head diversity. arXiv preprint arXiv:2605.20271.
Jihun Hamm and Daniel D. Lee. 2008. Grassmann discriminant analysis. In Proceedings of the 25th International Conference on Machine Learning, pages 376–383. doi:10.1145/1390156.1390204.
Mingu Lee, Jinkyu Lee, Hye Jin Jang, Byeonggeun Kim, Wonil Chang, and Kyuwoong Hwang. 2019. Orthogonality constrained multi-head attention for keyword spotting. In 2019 IEEE Automatic Speech Recognition and Understanding Workshop (ASRU), pages 86–92. doi:10.1109/ASRU46091.2019.9003738.
Jian Li, Zhaopeng Tu, Baosong Yang, Michael R. Lyu, and Tong Zhang. 2018. Multi-head attention with disagreement regularization. In Proceedings of the 2018 Conference on Empirical Methods in Natural Language Processing, pages 2897–2903. doi:10.18653/v1/D18-1317.
Jian Li, Xing Wang, Zhaopeng Tu, and Michael R. Lyu. 2021. On the diversity of multi-head attention. Neurocomputing, 454:14–24. doi:10.1016/j.neucom.2021.04.038.
Jack Merullo, Carsten Eickhoff, and Ellie Pavlick. 2024. Talking heads: Understanding inter-layer communication in transformer language models. In Advances in Neural Information Processing Systems 37, pages 61372–61418. arXiv:2406.09519.
Paul Michel, Omer Levy, and Graham Neubig. 2019. Are sixteen heads really better than one? In Advances in Neural Information Processing Systems 32. arXiv:1905.10650.
Catherine Olsson, Nelson Elhage, Neel Nanda, Nicholas Joseph, Nova DasSarma, Tom Henighan, Ben Mann, Amanda Askell, Yuntao Bai, Anna Chen, Tom Conerly, Dawn Drain, Deep Ganguli, Zac Hatfield-Dodds, Danny Hernandez, Scott Johnston, Andy Jones, Jackson Kernion, Liane Lovitt, Kamal Ndousse, Dario Amodei, Tom Brown, Jack Clark, Jared Kaplan, Sam McCandlish, and Chris Olah. 2022. In-context learning and induction heads. Transformer Circuits Thread. https://transformer-circuits.pub/2022/in-context-learning-and-induction-heads/index.html; arXiv:2209.11895.
Guilherme Penedo, Hynek Kydlíček, Loubna Ben allal, Anton Lozhkov, Margaret Mitchell, Colin Raffel, Leandro Von Werra, and Thomas Wolf. 2024. The FineWeb datasets: Decanting the web for the finest text data at scale. In Advances in Neural Information Processing Systems 37, Datasets and Benchmarks Track, pages 30811–30849. arXiv:2406.17557.
Belinda Phipson and Gordon K. Smyth. 2010. Permutation p-values should never be zero: Calculating exact p-values when permutations are randomly drawn. Statistical Applications in Genetics and Molecular Biology, 9(1). doi:10.2202/1544-6115.1585.
Qwen Team (An Yang, Baosong Yang, Beichen Zhang, et al.). 2024. Qwen2.5 technical report. arXiv preprint arXiv:2412.15115.
Qwen Team (An Yang, Anfeng Li, Baosong Yang, et al.). 2025. Qwen3 technical report. arXiv preprint arXiv:2505.09388.
Alec Radford, Jeffrey Wu, Rewon Child, David Luan, Dario Amodei, and Ilya Sutskever. 2019. Language models are unsupervised multitask learners. OpenAI technical report.
Paul M. Riechers. 2024. Geometry and dynamics of LayerNorm. arXiv preprint arXiv:2405.04134.
Gilbert Strang. 1993. The fundamental theorem of linear algebra. The American Mathematical Monthly, 100(9):848–855. doi:10.1080/00029890.1993.11990500.
Terence Tao and Van Vu. 2007. On the singularity probability of random Bernoulli matrices. Journal of the American Mathematical Society, 20(3):603–628. doi:10.1090/S0894-0347-07-00555-3.
Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N. Gomez, Łukasz Kaiser, and Illia Polosukhin. 2017. Attention is all you need. In Advances in Neural Information Processing Systems 30. arXiv:1706.03762.
Elena Voita, David Talbot, Fedor Moiseev, Rico Sennrich, and Ivan Titov. 2019. Analyzing multi-head self-attention: Specialized heads do the heavy lifting, the rest can be pruned. In Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics, pages 5797–5808. doi:10.18653/v1/P19-1580.
Kevin Ro Wang, Alexandre Variengien, Arthur Conmy, Buck Shlegeris, and Jacob Steinhardt. 2023. Interpretability in the wild: A circuit for indirect object identification in GPT-2 small. In The Eleventh International Conference on Learning Representations. https://openreview.net/forum?id=NpsVSN6o4ul.
Ruibin Xiong, Yunchang Yang, Di He, Kai Zheng, Shuxin Zheng, Chen Xing, Huishuai Zhang, Yanyan Lan, Liwei Wang, and Tieyan Liu. 2020. On layer normalization in the transformer architecture. In Proceedings of the 37th International Conference on Machine Learning, volume 119 of Proceedings of Machine Learning Research, pages 10524–10533. arXiv:2002.04745.
Hiroaki Yamagiwa, Yusuke Takase, and Hidetoshi Shimodaira. 2026. Measuring affinity between attention-head weight subspaces via the projection kernel. arXiv preprint arXiv:2601.10266.
Biao Zhang and Rico Sennrich. 2019. Root mean square layer normalization. In Advances in Neural Information Processing Systems 32. arXiv:1910.07467.