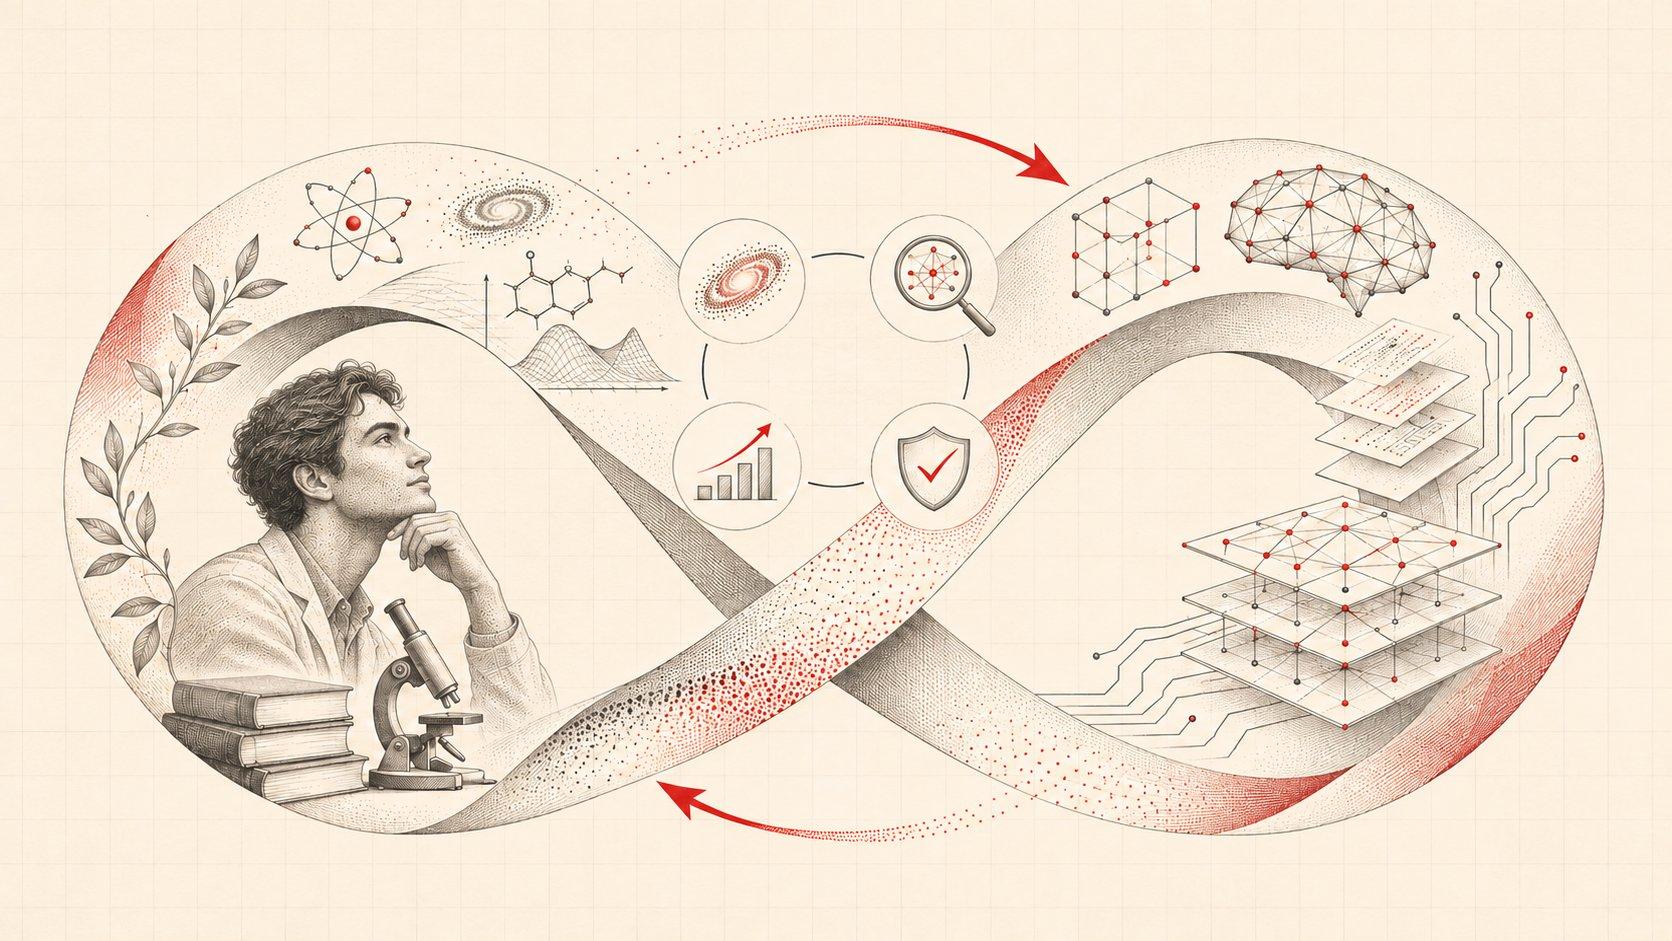
1. 再帰的自己改善が必要である
AIがAIを改善し、そのAIがさらに高度なAIを生み出す。Recursive Self-Improvement(RSI:再帰的自己改善)は、シンギュラリティを実現しうる重要な機構の一つとして、長く議論されてきた。
AIの開発競争が激化するなか、かつてはSFのように思われていた出来事が現実に起こり始めている。2026年には、OpenAIがAIによるミレニアム懸賞問題の一つ、Navier–Stokes問題の否定的解決を発表した。また、日本でもランサムウェア被害が拡大し、2026年上半期の被害報告は123件と半期で過去最多を記録した。
英国AI Security Institute(AISI)のFrontier AI Trends Reportでも、AIのサイバー能力が急速に向上する一方、評価したすべてのシステムで安全機構を回避する脆弱性が発見されたと報告されている。
シンギュラリティがいつ到来するかはわからない。しかし、AIが自らの開発に関与し、進歩を加速させる未来は現実味を帯びてきた。
こうした状況で、AIの再帰的自己改善の重要性を改めて説くのは野暮だろう。
ここで提案したいのは、我々人類の側も再帰的自己改善をするべきだということだ。
AIが人間を超える知能を獲得すれば、科学や技術、さらには社会が抱えるあらゆる問題を解決してくれるかもしれない。しかし、AIが進歩することと、それが人類にとって望ましい未来をもたらすことは同義ではない。
AIが高度化するほど、私たちがその振る舞いを理解し、安全性を確かめることは難しくなる可能性がある。だからこそ、人間はAIの進歩をただ享受するのではなく、その仕組みを理解し、評価し、制御する能力を高め続けなければならない。
加えて、人間が学び続ける理由は、安全性だけではない。AIが新しい科学的知識や計算原理を発見するなら、私たちもそこから学び、自らの理解を広げていきたい。世界を理解し、新たな問いを立てることは、それ自体が人間にとって価値ある活動だからだ。
さらに、AIが何を実現すべきかを決める人間の価値観や社会制度も、決して完成されたものではない。AIの進歩によって新たな可能性や問題が生まれるなら、私たち自身も何が望ましい未来なのかを問い直し続ける必要がある。
そして、本当に目指すべきは、AIだけが進歩する未来ではなく、人間とAIが互いの進歩を促す未来である。
AIが進歩することで人類が学び、人類が学ぶことでAIがさらに進歩する。
私たちは、そのような再帰的相互改善(Recursive Co-Improvement) の循環を実現したい。
2. 解釈とは何か — Semantic InterpretabilityからComputational Faithfulnessへ
再帰的相互改善の中でもっとも難しいのはAIの振る舞いを原理的に理解し制御することである。Mechanistic Interpretability(MI)は、ニューラルネットワークの内部計算を理解することに取り組んできた分野だ。
一つの方向性としてCircuitがある。ある出力が出るまでの内部の計算過程をどの内部特徴がどのような連鎖で発火したかを表すグラフとして記述する方法である。
その中で、個々のニューロンが複数の概念に反応するPolysemanticity(多義性)や、複数の特徴が同じ表現空間に重なり合うSuperposition(重ね合わせ)が問題になってきた。
そこで、SAEは内部表現を疎な特徴に分解し、TranscoderはMLPの計算を疎な特徴間の関係として近似することで、回路の解析を容易にしようとしてきた。さらに、抽出した特徴を自然言語で説明する手法も発展し、意味的に理解しやすい特徴や回路を発見することが、解釈可能性研究の重要な成果として位置付けられるようになった。
しかし、私たちは、こうしたアプローチが人間にとっての意味的な理解を重視しすぎていないかと考えている。
人間にとって意味的に理解しやすいことと、モデルが実際に行っている計算に忠実であることは、同じではない。
例えば、CPUやGPUの動作を理解するとき、その内部信号を「推論」「判断」「記憶」といった人間に馴染みのある概念に対応づけても、実際の演算や情報の流れを理解したことにはならない。
ニューラルネットワークについても同様である。内部信号を意味的に解釈しやすい表現へ変換したとしても、その表現が元の計算機構を正しく捉えているとは限らない。再構成精度が高いことや、特徴に名前を付けられることだけでは、計算の忠実性は保証されない。
そこで、私たちは解釈を次のように定義したい。
解釈とは、対象の内部計算に忠実な形で、その振る舞いを説明・予測する原理を発見することである。
重要なのは、人間が既に知っている概念を見つけることではなく、モデルの振る舞いを原理的に予測できるようになることだ。
モデルが内部信号をどのように区別し、読み取り、変換し、その結果として何が起こるのか。さらに、内部計算に介入したとき、振る舞いがどう変化するのか。
まずはその仕組みを素直に観察し、原理を明らかにする。
発見した原理に既存の言葉が対応するとは限らない。しかし、それで構わない。新しい原理を発見したなら、それを新しい概念として定義し、名前を与えればよい。
モデルを人間の既存概念に合わせるのではなく、モデルから学ぶことで人間の概念体系そのものを拡張する。
これが、私たちがSemantic InterpretabilityよりもComputational Faithfulnessを優先したい理由である。
近年、Google DeepMindがSAE研究の優先度を引き下げたことや、GoodfireのNick CammarataがNeural Networks Are Already Cleanにおいて、ネットワーク自身の計算機構を直接研究する立場を提唱したことも興味深い。
もちろん、SAEやTranscoderが無価値だというわけではない。私たちが問い直したいのは、解釈可能性研究において、何をもって「理解できた」とするのかという評価基準そのものである。
3. AIを理解することは、何を可能にするか
計算機構に忠実な解釈を追求することには、単にモデルの振る舞いを説明する以上の価値がある。
Interpretability for Science — AIから人間が学ぶ
第一に、人間が新しい科学的知識を獲得する可能性がある。
AIは学習を通じて、人間が明示的に設計していない表現や計算機構を獲得する。私たちがそれらを忠実に理解できれば、新しい概念、アルゴリズム、科学的仮説を発見できるかもしれない。
実際にGoodfireは、ゲノム基盤モデルEvo 2の内部表現から生物の系統関係に対応する幾何的構造を発見した。また、Prima Menteとの共同研究では、アルツハイマー病の新しいバイオマーカー候補を特定している。
こうした研究では、モデルが既存の科学的知識をどのように表現しているかを理解することと、モデルから人間が知らなかった知識を発見することを区別する必要がある。後者には、モデルの外部での科学的検証も欠かせない。
私たちは、特に材料科学の基盤モデルに注目し、計算機構の解析と化学のドメイン知識を融合させることで、新しい科学的知識を獲得する方法論を探究したい。
優れた予測能力を持つモデルの内部計算を忠実に理解し、そこで発見した規則性を化学的な知識と結びつける。それによって、材料の構造と物性の関係について新しい仮説を立て、材料設計の原理として抽象化できるかもしれない。
そして、発見した原理を人間が理解するだけでなく、次のAIの学習や設計にも還元したい。 例えば、新たに得られた構造と物性の関係を生成条件や学習目標に反映させることで、材料探索そのものを改善することが考えられる。
AIの内部計算から原理を発見し、人間がそれを科学的に検証・体系化し、再びAIの改善へとつなげる。
これは、AIが新しい知識を発見して終わるのではなく、人間の学習そのものが次のAIの進歩に貢献するという方向である。
Interpretability for Safety — 理解を安全性の改善に還元する
第二に、AIの安全性をより原理的に理解し、制御する可能性がある。
従来の安全性評価では、どのような入力によってモデルが危険な振る舞いを示すかを調べる。しかし、それだけでは、その振る舞いがどのような内部計算によって生じたのかはわからない。
もし、安全性に関わる計算機構を忠実に理解できれば、なぜ安全性が破られるのかを原理的に説明し、未知の状況での失敗を予測できる可能性がある。
さらに、その知識を利用して内部計算を制御し、事後学習によって安全性を改善することも考えられる。
これは単に出力の良し悪しからモデルを最適化するだけでなく、なぜその振る舞いが生じるのかという理解に基づいて、安全性を改善するという方向である。
同じ考え方は、モデルのアーキテクチャや学習アルゴリズムの改善にも応用できるだろう。
もちろん、Computational Faithfulnessを優先する方法論が既存手法より優れているかは、今後の実験で示さなければならない。しかし、計算原理を理解し、その知識を新たな状況での予測や制御に利用することは、解釈可能性の有効性を評価する重要な基準になると考えている。
4. 私たちの研究とこれから
私たちは現在、Transformerの内部計算を、アーキテクチャに根ざした単位から理解する研究を進めている。
Attention Reading/Writing Subspacesでは、Attention Headの読み書き空間を線形代数的に定式化し、Projection Kernel(PK)によって部分空間の間の結合を解析した。
Head-Exclusiveでは、ヘッド間の読み書きの幾何を制御したTransformerを訓練し、幾何的な排他性が必ずしも機能的な独立性を意味しないことを検証した。
KV Cache Swapsでは、KVキャッシュへの介入を通じて、Keyによって参照されるValueが対応する情報を保持するという仮説を検証した。
これらに共通するのは、人間があらかじめ設定した意味的特徴を探すのではなく、モデルが実際に行っている計算と、その構成要素の因果的な関係を理解しようとする姿勢である。
今後はPKを利用して計算経路の候補を特定し、因果的な検証によって、モデル本来の計算単位に基づくCircuit解析へ発展させたい。
また、Interpretability for Scienceでは、材料科学の基盤モデルに対する機械論的解釈可能性の研究を、化学のドメイン知識と融合させて推進する。
優れた物性予測・材料生成能力を持つモデルの内部計算を、Computational Faithfulnessを重視して解析し、材料の構造と物性を結びつける新しい原理の発見を目指す。
さらに、発見した原理を化学的に検証・抽象化し、モデルの学習や材料生成に還元することで、人間の科学的理解とAIの材料探索能力を同時に高め、新材料の発見につなげたい。
安全性に関しては、Computational Faithfulnessを重視したCircuit解析を通じて、AIの危険な振る舞いを原理的に理解・制御するための基礎研究を進める。
同時に、英国AISIのオープンソース評価基盤Inspectへの貢献を通じて、モデル内部に潜む欺瞞的な振る舞いやBackdoorの検出・評価にも取り組む。
さらに、マルチエージェントに対する監視・制御の仕組みを研究し、AIの誤作動を実運用環境で検出・抑制する技術の確立を目指す。
計算構造を理解し、そこから得た知識を現実の改善へ還元する。これが私たちの研究に共通する方針である。
5. Recursive Co-Improvement
AIが自らを改善し、さらに高度なAIを生み出す。Recursive Self-Improvementは、AIの進歩を加速させる構想である。
しかし、私たちはAI自身の能力向上だけでなく、その進歩を人間の知識の進歩にもつなげたい。
解釈可能性研究の目的を、人間の既存概念によるモデルの説明に限定する必要はない。
モデルが実際に行っている計算を忠実に理解し、その振る舞いを説明・予測する原理を発見する。そして、その原理にまだ名前がなければ、新たな概念として人間の知識に取り込めばよい。
さらに、その知識を利用してAIの能力や安全性を改善する。改善されたAIを再び研究することで、新しい原理を発見し、次の改善へつなげていく。
AIの理解 → 人間の学習 → AIの改善 → 新しいAIの理解。
この循環を、本稿ではRecursive Co-Improvement(再帰的相互改善)と呼びたい。
これは、人類が人間らしい活動を維持しながら、AIと共進化するための構想である。
AIの進歩をただ享受するのではなく、そこから学び、世界への理解を深め、新たな知識を生み出し続ける。
そして、その知識によってAIをより深く理解・制御するとともに、何を目指すべきかを自ら問い直し、次のAIの進歩を方向づけていく。
AIに知的活動を委ねきるのではなく、人間自身も学び、考え、創造する主体であり続けたい。
もちろん、この循環を成立させるには、計算原理の発見、その一般化、そしてモデル改善への還元という課題を解く必要がある。
私たちは、そこに取り組みたい。
AIを理解することで、人間がより賢くなる。そして、その人間がAIをより賢く、より安全にする。
Recursive Self-Improvementだけではない。
Recursive Co-Improvementこそ、私たちが目指すAI研究の姿である。