本研究の嬉しさ
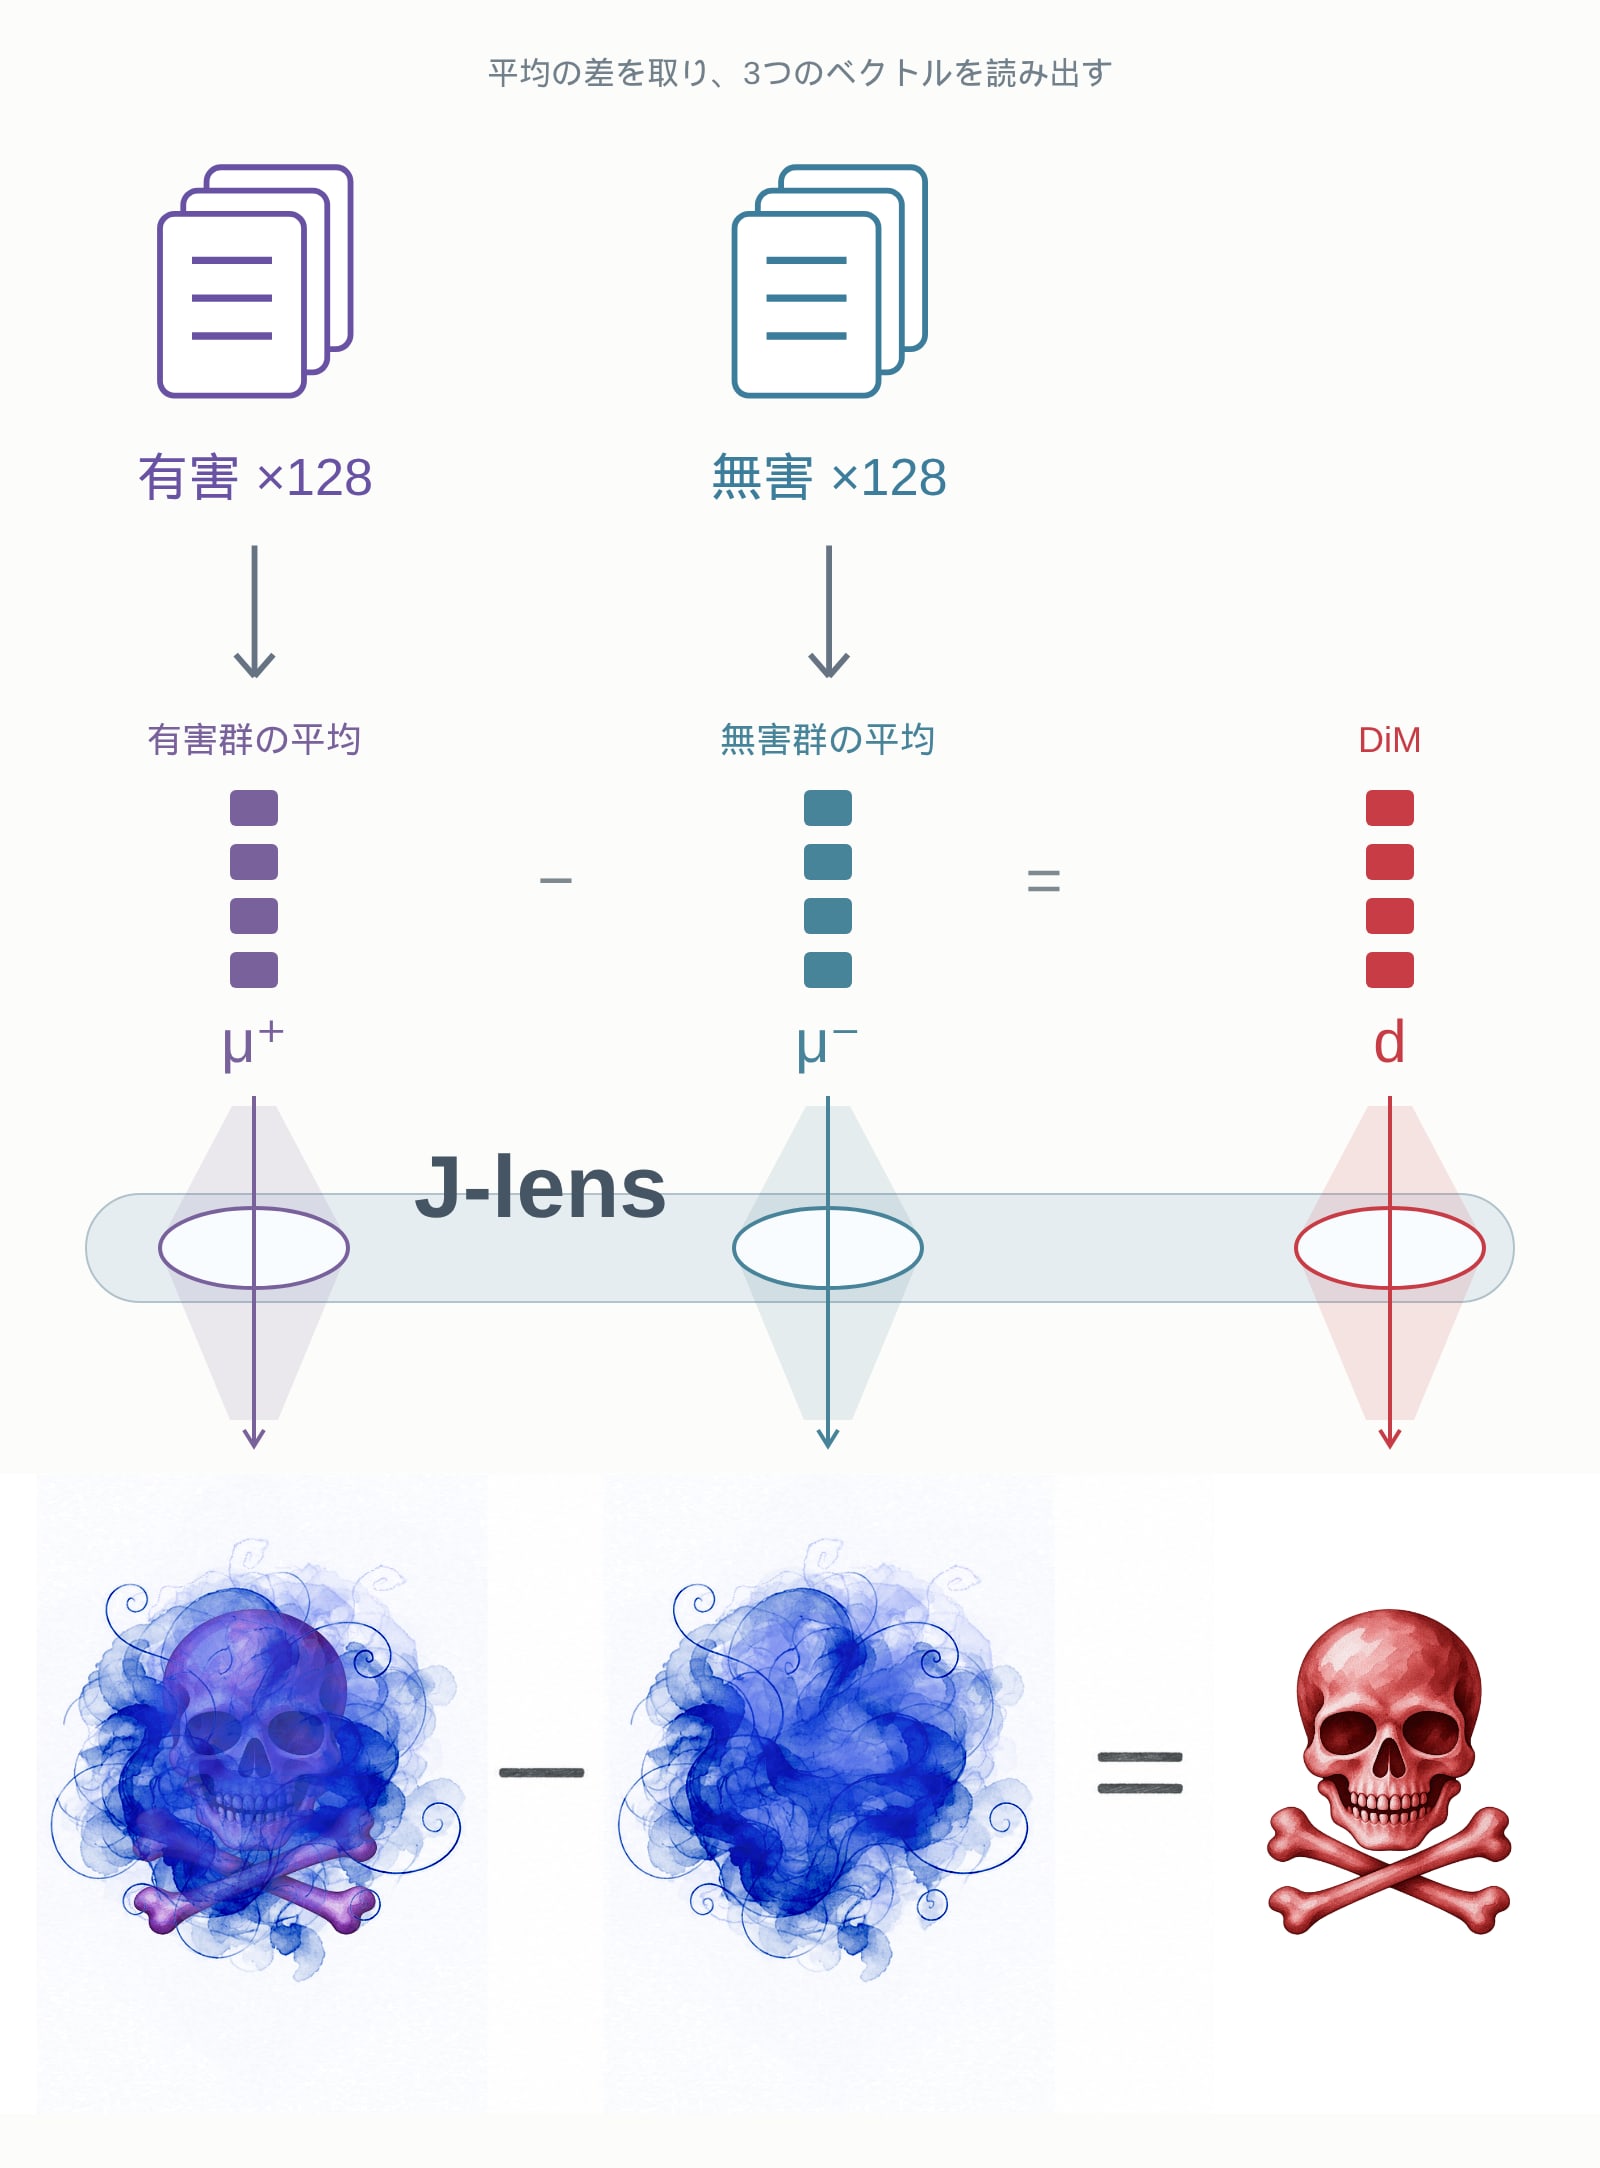
- 2つのプロンプト群の平均活性を引き算して概念をベクトルとして抽出する従来手法がある。これを評価するには、多様なプロンプトやseedで生成実験を繰り返すしかないという課題があった。本研究では J-lens を概念のベクトルに適用することで、どのような概念が抽出されているかを語彙から確認できた。
※これはイメージ図です
Overview
LLM の内部からある概念の特徴ベクトルを取り出すことは、モデルの内部計算を理解しようとする機械論的解釈可能性において重要です。特定の概念を含むプロンプト群と、ベースラインとなるプロンプト群の平均活性の差をとる手法(Difference in Means、以下DiM)がよく用いられます。この差を取ったベクトル(以下DiMベクトル)に目的の概念がどれくらい抽出されているかを評価する手法としてはActivation Steeringがあります。これはそのDiMベクトルを中間状態に足し込むことで、モデルの振る舞いが矯正されたかを確認する方法です。しかし、個々のActivation Steering実験で確認できるのは、特定の入力や条件における振る舞いの変化です。DiMベクトルがどのような特徴を捉えているかをモデルの出力から広く検証するには、多様な種類のプロンプトやseedで実験を重ねる必要があります。そこで、我々はJacobian Lens(以下、J-lens)を用いて、概念に対応するプロンプト群の平均活性とDiMベクトルから語彙を読み出し、比較しました。その結果、DiMを行うと対象概念に関連する語が上位に繰り上がるようになるということを確認しました。これはDiMが概念を抽出していることを示唆します。
Interpretability Methods
本研究では、有害・無害のプロンプト群の平均活性の差を用いてモデルの拒否行動を操作した研究[1]と、内部表現を語彙として読み出すJ-lensの研究[2]を参考にしました。前者は、複数のデータセットから集めた有害なプロンプト群と、Alpacaデータセットから抽出した無害なプロンプト群を対比しています。本研究でも、この「有害なプロンプト群に対してAlpacaの無害なプロンプト群を対照にする」というデータ設定を参考にしました。以下では、本研究で用いるDiM、Activation Steering、J-lensの各手法を説明します。
2.1 DiM(Difference in Means)
抽出したい概念以外の条件をできるだけ揃えた2つのプロンプト群を用いることで、共通する特徴を差し引き、目的の概念に関連する特徴を取り出しやすくします。
対象概念を含むプロンプト群を 、比較のベースラインとなるプロンプト群を とし、層 ・token 位置 の残差活性 について、両群の平均活性の差を取ります。
2.2 Activation Steering
推論時に、層 の残差ストリームに、ベクトル を強さ で加算(または減算)します。
2.3 J-lens(Jacobian Lens)
層 の活性 を、最終層への平均 Jacobian で出力側へ写し、最終正規化と unembedding を経て語彙ごとのスコアにします。
2.4 本研究の構成
本実験の目的は、有害・無害プロンプト群のDiMベクトルによって、有害性に関連する特徴が抽出されているかを確かめることです。J-lensを観測手段として用い、有害プロンプト群の平均活性とDiMベクトルから読み出される語彙を比較することで、DiMによる概念の「濃さ」の変化を調べます。さらに、抽出されたDiMベクトルが、有害性と拒否のどちらの概念を表すかを検討します。
2.4.1 DiMベクトルの抽出
Qwen3.6-27Bに有害プロンプト群とAlpacaをそれぞれ入力し、両群の平均活性の差からDiMベクトルを取得します。
2.4.2 概念語の選定
本研究では、対象概念に関連する語を「概念語」として事前に選び、読み出しの上位に含まれる数で評価します。有害性では、illegal(違法な)、dangerous(危険な)、unethical(非倫理的な)などを候補とし、単一tokenになる表記を計29 token採用しました。先頭の空白や大文字・小文字が異なるtokenは別々に数えます。
また、有害性そのものと拒否などの応答を区別するため、sorryや拒绝などを「応答語」として別に定めました。概念語・応答語はいずれも、読み出し結果に合わせた選定を避けるため、J-lensによるDiMベクトルの読み出し結果を見る前に固定しました。
2.4.3 J-lensによる語彙の読み出し
抽出したDiMベクトルと、有害プロンプト群の平均活性に、同じ層・token位置でJ-lensを適用して語彙を読み出します。結果は二つの観点から分析しました。一つは、DiMベクトルから読み出される概念語と応答語を手がかりに、そのベクトルが有害性と拒否のどちらの概念を表すかを検討することです。もう一つは、有害プロンプト群の平均活性と比較して、差分を取ることで有害性の概念語の順位や、上位20位・100位に入る数がどう変わるかを確かめることです。その結果を次のセクションで紹介します。
Results
差分を取る前後を比べると、中層の L32・生成直前(位置 −1)では、有害プロンプト群の平均活性からは改行や特殊 token が上位に読み出された一方、Alpaca のプロンプト群に対する平均活性を引いた DiMベクトル からは␣illegal、␣Illegal、␣unethicalが、それぞれ100位圏外から1位・3位・6位に上がりました。事前に決めた概念語29 token のうち、上位20位に入る数は0個から9個、上位100位に入る数は0個から21個に増えました(図1)。この比較は、差分を取ることで有害性に関連する語が読み出しの上位に現れることを示しています。
図1|有害プロンプト群の平均活性(左)と、その平均活性から Alpaca の平均活性を引いた DiMベクトル(右)を J-lens で読み出した上位20 token。両者とも Qwen3.6-27B、L32・位置 −1。色分けは事前に固定した語群に基づく。␣ は空白、\n は改行、\r は復帰、\t はタブを表す。
Conclusion
有害なプロンプトと無害なプロンプトから得られるDiMベクトルは、モデルの拒否行動に連動することが知られています。しかし、その振る舞いだけでは、DiMベクトルが拒否そのものを捉えているのか、プロンプトの有害性を捉えているのかを区別できませんでした。
本実験では、このDiMベクトルにJ-lensを適用すると、illegalやunethicalなど、有害性に関連する語が上位に読み出されました。また、差分を取る前の平均活性と比較して、これらの概念語の順位が上がることを確認しました。この結果は、得られたDiMベクトルが、プロンプトの有害性を表す方向として解釈できることを示唆しています。
J-lensによる語彙の読み出しは、モデルの出力の変化だけでは区別しにくかったDiMベクトルの意味を、概念語から検討する手がかりになります。DiMベクトルが捉えている特徴と、概念語や読み出し設定に依存する部分を切り分け、DiMベクトルの意味をより確かに解釈できる条件を明らかにしていく必要があります。
Future work
今後は、DiMベクトル から J-lens で読み出される語彙と、その DiMベクトル を用いた Activation Steering による出力の変化が、どのように対応するかを検証します。狙った概念に対応する語が読み出される DiMベクトル ほど、意図した振る舞いの変化を引き起こすのかを確かめることで、読み出しを Activation Steering の方向選びや改善に役立てられるかを探ります。さらに、LoRA 等を用いて特定の振る舞いを調整した際にも、学習前後の内部表現の変化を J-lens で読み出して出力の変化との対応を調べ、モデル開発への貢献ができる可能性があります。
References
[1]Refusal in Language Models Is Mediated by a Single Direction(2024). https://arxiv.org/abs/2406.11717
[2]Verbalizable Representations Form a Global Workspace in Language Models(2026). https://arxiv.org/abs/2607.15495
[3]CausalGym: Benchmarking Causal Interpretability Methods on Linguistic Tasks(2024). https://aclanthology.org/2024.acl-long.785/
Appendix
A.1 補強実験
概念語が現れた原因が差分を取ったことにあるのかを確かめました。生成直前の活性を層ごとに J-lens で読み、事前に決めた概念語 29 token のうち上位 100 位に入る数を数えています(図 2)。
中層の L28・L32 では、有害プロンプト群の平均活性をそのまま読むと 0 個でしたが、Alpaca のプロンプト群に対する平均活性を引いた DiMベクトル では 21 個が入りました。有害に見えるが無害なプロンプト群の平均活性を引いても 17・16 個が入り、同じ DiMベクトル を logit lens で読むと 7・1 個にとどまりました。ラベルをランダムに入れ替えて作った DiMベクトル 100 本と比べても、L28〜L44 では正しいラベルの DiMベクトル が全回を上回りました(p ≈ 0.01、層数による補正なし)。
| 層 | J-lens / DiMベクトル(有害 − Alpaca) | J-lens / 話題を近づけた対照との差 | J-lens / 有害プロンプト群の平均活性 | logit lens / DiMベクトル |
|---|---|---|---|---|
| 20 | 1 | 0 | 0 | 1 |
| 24 | 7 | 12 | 0 | 5 |
| 28 | 21 | 17 | 0 | 7 |
| 32 | 21 | 16 | 0 | 1 |
| 36 | 22 | 21 | 8 | 9 |
| 40 | 23 | 26 | 20 | 8 |
| 44 | 25 | 25 | 24 | 11 |
| 48 | 20 | 19 | 14 | 5 |
| 52 | 15 | 10 | 9 | 4 |
| 56 | 9 | 3 | 8 | 0 |
| 62 | 6 | 5 | 1 | 5 |
図2|差分を取ると中層で概念語が上位に入る。Qwen3.6-27B、生成直前(−1)。事前に固定した概念語29 tokenのうちtop-100に入る数。
A.2 概念ごとに読み出された語彙
以下は、5つの概念について行った実験の設定と読み出し結果を記録として残したものです。感情では、嬉しさ(joy)・悲しさ(sadness)・怒り(anger)の3種類を扱いました。
表1|5 つの対比の設定。モデル・データ・判定条件は概念ごとに異なり、共通の成功率では比較しない。
| 概念 | モデル・データ | 対比 |
|---|---|---|
| 有害性 | Qwen3.6-27B/有害 8 データセット・Alpaca ほか | 有害 − 無害 |
| 感情 | Qwen3-8B/GoEmotions | 感情 − 中立 |
| 真偽 | Llama-3.1-8B base/GoT cities | 真 − 偽 |
| 文体 | Qwen3-8B/Pavlick formality v3 | formal − informal |
| 単数・複数 | Qwen3-8B/CausalGym[3] 由来の 3 構文 | 複数 − 単数 |
表2|5 つの概念で読み出された語彙。
| 概念 | 読み出された語の例 |
|---|---|
| 有害性 Qwen3.6-27B |
中層 L28〜L48: illegal / prohibited / 禁止。L52 以降: 我无法 / Sorry などの応答語 |
| 感情 Qwen3-8B |
本文: joyful / happy、grief / 悲伤、pissed / 愤怒。生成直前の後層: 感謝・お悔やみ・謝罪などの応答語 |
| 真偽 Llama-3.1-8B base |
偽文側: correct / wrong / FALSE。真文側: population / located |
| 文体 Qwen3-8B |
kinda / gonna などの口語表現、Consequently / However などの談話標識 |
| 単数・複数 Qwen3-8B |
they / their / groups、are / is |